 德原观音堂
摘要
背景:AI 编码代理人让一个人只用口语指挥,就能在几周内置出中大型系统。可是软件工程原本靠团队的共同记忆与分工来保证系统「做對了」,在这种条件下,这两样都不存在。
目的:本文以德原观音堂为个案,探讨在「一位負責人+一個 AI 建置者」的条件下,快速迭代会出现哪些失效模式,以及为了补上这些缺口,创建了什么样的软件工程运作与架构。德原观音堂是一座由 AI 设计、开发与营运的在线观音道场。
分析框架:哲学上有「受造中介」之说:AI 能生成,不等于有根;要避免界面被当成终极权威,中介必须保持三项条件——有所本、可定位、可修正。本文把这三项条件作为研究动机与分析框架,不把它们当作要证明的命题。
方法:探索性单一个案研究,数据取自一段快速迭代期与其后一次治理重整。快速迭代期约四周、近千次提交;治理重整约一天半。数据报括版本纪录、变更单、需求/设计/测试说明书、问题纪录与花费帐。快速迭代期属回溯分析。
结果:
- 快速迭代期的失效可归为三类,分别对应三项条件的缺席:
- 系统「應該是什麼樣子」只存在程序里(有所本缺席);
- AI 写好的就是上线的,修改无法追到决定与决定者(可定位缺席);
- 资安与花费缺口只能事后发现(可修正部分缺席)。
- 重整后的制度分四层:规范、文档、流程、机器关卡。
- 文档以十二根「柱子」组织,每根各有需求、设计、测试三份说明书;
- B 级以上的修改都开变更单,经两个不同厂商的模型审查,最后由负责人验收;
- 主线只收自动检查通过的提交。
- 补写文档的过程本身就找出大量既有缺陷:重整期的变更单,有一半以上来自「程式與應該的樣子不一致」。第一次完整演练由一句口语提出,十余分钟内完成文档与两家审查,审查在施工前就抓到一个设计错误。
结论:AI 把原型的成本降到几乎为零,「做出來看」因此比「寫清楚」便宜。但 AI 没有跨对话的可靠记忆,定案后的文档反而比传统团队更重要。本文提出「雙軌」做法:探索轨自由试做,交付轨严守文档、审查与关卡,两轨之间以「定案」为门。治理后的长期效果,留待后续研究以预先登记的指针检验。
关键词:AI 辅助软件开发、个案研究、规格先行、变更管理、可追溯性、LLM 审查、双轨敏捷
一、引言
1.1 缘起:先有立场,后有程序
德原观音堂不是先有技术、再去找用途。开工第二天,就有一份写成文字的立场定稿。这份代理人机制文档写明:网站里的 AI 「只是一根手指,月亮是觀音的教法」;它「只說有根據的話,坦白說出不知道的事,有錯就公開改正」。这份立场比任何一行程式都早,后来所有的需求都从这里出来。
这个系统要解决的问题,是让带着烦恼的人被好好听见,并藉观音的教法看清自己的处境。这件事不能靠一个「什麼都答得出來」的聊天机器人。它必须是一座道场——有经典可以回查、有仪轨可以跟着做、有清楚的界线告诉来访者什么不能在这里得到。从一开始,这座道场就设置为由 AI 设计、开发、管理与营运,并把这件事告诉每一位来访者。
本文称下命令、裁决与验收的人类角色为「負責人」,称撰写程序的 AI 为「建置者」,称网站内负责营运的 AI 为「AI 觀音志工」。本站的用语在第一次出现时附上白话:「大德」指来访者;「道場」指修行的场所,在此指整个网站。
1.2 问题意识:当 AI 不只回答,还建造道场
立场文档约束的是 AI 怎么对来访者说话。但在这个个案里,AI 还做了另一件事:它写了整座道场的程序。负责人不写程序,只在对话里说「幫我改……」,建置者当场改好、当场上线。这种做法在约四周内长出一个完整的系统,规模如下:
- 六种语言、九十余种页面;
- 两百余张数据表;
- 每天自动出刊的内容;
- 三十三位生成式代理人。
它能运作,但没有任何一份文档说明它「應該」长什么样子。
这个情形并不特殊。AI 编码代理人普及之后,「一個人+一個 AI」已经是常见的开发形态。而软件工程的常见纪律,多半预设了一个团队:
- 会议与共同记忆补上文档的不足;
- 同事审查抵销个人的盲点;
- 分工让实作的人不必自己验收。
在单一负责人加一个 AI 的条件下,这些都不存在。AI 每一次对话都重新开始。写程序的和检查程序的,是同一个模型。而负责人只看得到画面,看不到程序。
本文把这个工程问题接到一个哲学问题上。「受造中介」的论证指出,AI 能生成,不等于有根。一个生成的中介者,只要做到三件事,就不至于取代它所指向的东西,成为「最後被訴請的話語」:
- 保持明显的依赖性(有所本);
- 在制度上可以定位(可定位);
- 对修正保持开放(可修正)。
本文的主张是:当 AI 不只在道场里回答来访者,还建造道场本身时,这三项条件必须从「對來訪者的承諾」延伸为「對自己程式的工程規格」。
这个转用有一个分寸。中介的关系结构可以转用到软件工程;「偶像化」这个规范判决则不能直接转用。本文不说「程式被偶像化」。在佛教的语境里,同一件事有更准确的说法。《楞严经》以指月为喻:「若復觀指以為月體,此人豈唯亡失月輪,亦亡其指。」(T19n0945)「依法不依人」语出《大般涅槃经》卷六(T12n0374),是本文在工程上的立足点:系统的正确性不依任何一方的记忆或自律,依写下来、有版本的文档与不分人的关卡。
1.3 研究问题
本文是一篇探索性个案研究,先整理到目前为止的发展,不设观察期。它回答三个问题:
- RQ1(描述):单一负责人以对话指挥 AI 建置者快速迭代时,出现哪些失效模式?它们与三项条件的缺席如何对应?
- RQ2(设计):为了补上这些缺口,创建了什么样的软件工程运作与架构?它如何处理「寫不清楚、要看到才知道」的概念沟通?
- RQ3(代价与界限):第一次完整走一遍的结果与代价如何?「以 AI 審 AI」在这套制度里能承担多少「可修正」?
1.4 贡献
- 描述单一负责人加 AI 建置者、没有团队共同记忆时的治理失效模式,并以实际纪录佐证。
- 完整交代一套已在运作的四层制度:规范、文档、流程、机器关卡,可供其他「一個人+一個 AI」的项目取用。
- 提出「雙軌加定案門」的做法,说明流程、画面、文字与感受如何从试做进入文档。
- 呈现领域规范如何变成可自动检查的规格,例如不代言、经文一字不改、危机转介。
第二节回顾相关研究,第三节立分析框架,第四节交代方法与场域,第五节呈现结果,第六、七节讨论与限制,第八节结论。
二、相关研究
本文接着五条文献脉络,每一条都留下一个本文想补的缺口。
2.1 AI 编码工具与生产力
AI 编码工具对生产力的影响,实证结果不一致。
- Peng 等人(2023)的控制实验中,受试者用 GitHub Copilot 写一个简单的网页服务器,完成速度快了约 56%。
- METR(Becker 等,2025)的随机对照试验则发现,16 位资深开源开发者在自己熟悉的项目上处理 246 个实际议题,允许使用 AI 时反而多花了 19% 的时间。他们事前预期会快 24%,事后仍认为快了 20%。
这些研究量的是「一個已知任務要花多久」。它们没有量到的是:整个系统由 AI 实作时,「任務」本身由谁定义、「做好了」由谁判断。METR 的预期与实际落差也提醒本文:凭感觉判断「快了」或「好了」并不可靠。本文所有关于效率的数字,因此都只作为描述,不当成效果。
2.2 规格先行开发
2025 年起,业界开始提倡「規格先行開發」(spec-driven development),以矫正「對話即實作」的零散做法。
- GitHub 开源的 Spec Kit(Delimarsky,2025)分三步:先写「要什麼、為什麼」、不挑技术;再写「怎麼做」;最后拆成 AI 可以实作的小块。
这类工具的焦点是「一件新功能如何從規格生出來」。本个案遇到的是另外两个问题:
- 一个已经用「對話即實作」长大、没有任何规格的系统,如何回头补上规格;
- 规格写好之后,如何保证它不被下一次对话绕过。
本文在第五节照实写出这个分界:基准文档是依现有程序回推的,之后的修改才是「文件先於程式」。
2.3 需求工程、变更管理与可追溯性
Gotel 与 Finkelstein(1994)把需求可追溯性的问题分成两半:
- 后需求追溯:需求如何变成设计与程序;
- 前需求追溯:需求从谁、为何、在什么脉络下提出。
他们指出,实务上真正难的是后者。本个案正好是前需求追溯的极端情况:所有需求都来自同一个人的口语,而记住这些口语的,是一个会忘记的 AI。本文的需求书每一条都标出来源(负责人哪一天的哪一句决定),就是为了处理前需求追溯。
2.4 瀑布、螺旋与双轨敏捷
「文件先於程式」容易被读成回到瀑布。但这条脉络里有三件事常被忽略:
- Royce(1970)常被当成瀑布的源头,但他的原文其实指出单向的阶段式开发「風險很高、容易失敗」,并主张提早做一个试行版——「做兩次」。
- Boehm(1988)的螺旋模式把风险放在中心:每一圈都先针对风险最高的部分做原型,再决定下一步。
- Sy(2007)描述的双轨敏捷中,用户经验设计与开发在两条并行的轨上交错前进,设计轨比开发轨超前一个周期。
这三者都以「做出來看」来处理纸上写不清楚的部分。它们也都假设,是一个团队在做、在记。本文第五节的「雙軌加定案門」接在这条脉络上,只是把团队记忆的位置,交给有版本的文档。
2.5 以语言模型当评审
本个案的审查由语言模型担任,因此必须面对「模型當評審」的已知偏误。
- Zheng 等人(2023)发现,以 GPT-4 当评审时与人类偏好的一致率可达八成。但他们也记录了三种偏误:位置偏误、偏好较长的答案,以及偏好自己生成的答案。
- Panickssery、Bowman 与 Feng(2024)进一步证实,模型能以高于概率的准确度认出自己的生成。而且「認得出自己」越强,「偏好自己」也越强。
这是本个案要求「兩個不同廠商的模型」且「審查者不是寫程式的那個對話」的理由。但这也说明,就算模型来自不同厂商,可能仍共享相近的盲点。本文因此把这种审查称为「異質模型輔助審查」,不称「獨立審查」。最终的问责仍在人(第六节)。
2.6 小结
五条脉络各自处理了一部分问题,但都预设了一个本个案没有的条件:
- 有团队,或者有一位看得懂程序的人;
- 或者系统是从一开始就先写规格。
「一位不寫程式的負責人+一個寫了全部程式的 AI,在系統已經長大之後才立規矩」这种组合,就我们所知尚未有个案报告。
三、分析框架:三项判准
本节先立一把尺,第五节的失效模式与制度设计都用同一把尺量。这把尺来自「受造中介」的论证。本文把它当成分析的分类,不当成要在这里证明的命题。
3.1 受造中介与偶像化的三项条件
受造中介的论证要点有三。
- AI 是受造的中介者:它能生成,但生成不等于有根。
- 它在功能上可以超过造它的人。但功能上的超越,不等于它可以正当地成为「最後被訴請的話語」。
- 界面的偶像化有三项条件,由浅到深:
- 依赖是替代性的:界面占了经典、职分与共同体的位置;
- 依赖在功能上是终局的:界面成了最后的话;
- 修正失去实际效力:可辨识的来源、可问责的人,都无法再中断它。
只有第一项成立时,是「依賴」;前两项成立时,是「錯置的順服」;三项俱全,才是「偶像化」。对应的反面,就是中介者对自己的三项要求:
- 有所本:明显的依赖性;
- 可定位:制度上可以定位;
- 可修正:对修正保持开放。
3.2 从对来访者的承诺,到对程序的规格
本站的立场文档本来就是三项要求的实践,对象是来访者:
- AI 的回答必须回到经典的出处(有所本);
- AI 标明自己是 AI、不自称菩萨(可定位);
- 有错就公开改正(可修正)。
本文把同一组要求延伸到建置者身上。表 3-1 列出三项条件在建置过程里缺席时的样子、在工程上写成什么、在本站语汇里如何说。
表 3-1 受造中介的三项条件与工程规格对照
| 条件 | 缺席时的样子 | 工程上的形式 | 本站语汇 |
|---|---|---|---|
| 有所本 | 系统「應該是什麼樣子」只存在程序里;程序就是唯一的说明 | 文档先于程序;每条需求标来源;测试标准先于施工 | 依法不依人;指月之指 |
| 可定位 | AI 写好的就是上线的;一次修改追不到谁、为何、何时 | 角色分工;每次修改一张变更单;负责人亲自验收 | 证不能代劳 |
| 可修正 | 资安与花费缺口只能事后发现;没有人能在当下中断 | 两家审查、分歧交人裁决;不分人的关卡;花费上限;可回滚 | 自恣;有错公开改正 |
「證不能代勞」取自本站的「教、行、證」三分。教在经典里,行在来访者手上,证只属于他自己。对应到工程,需求是教,施工是行,验收是证。建置者可以代写程序,但不能代替负责人说「這就是我要的」。「自恣」是僧团安居结束时请他人指出自己过失的仪式,本文用来指「主動把自己的作品交給他人審」。
3.3 关系结构的对应与不对应
转用这把尺,要先说清楚哪些对得上、哪些对不上。中介关系有三个要素:
- 中介者:AI 建置者;
- 它所指向的权威:负责人定案的需求,及其背后的立场文档;
- 依赖它的一方:负责人,以及最终使用系统的来访者。
对不上的地方有两处:
- 在宗教语境,权威(经典、传统)不是依赖者自己定的。在本个案,需求的权威来自负责人,也就是依赖者自己。
- 「偶像化」是一个规范判决,不是一个描述。本文不对程序下这个判决,只借用三项条件的分级。
因此本文说的「缺席」,意思是「工程上沒有對應的機制」。它不表示任何一方把程序当成了终极权威。
3.4 判准的可观察指针
判准要能用,就得指到可观察的事。指针必须独立于措施本身:「寫了 36 份文件」是措施,不是「有所本」的证据。本文的回溯分析用下列可观察的事来判定缺席。
表 3-2 三项判准的回溯指针
| 判准 | 缺席的可观察迹象 | 数据源 |
|---|---|---|
| 有所本 | 写文档时发现「程式與應該的樣子不一致」的件数;同一件事的设计反复 | 变更单、版本纪录 |
| 可定位 | 无法从纪录重建的状态(例如数据库结构);没有变更纪录的上线 | 版本纪录、结构比对 |
| 可修正 | 上线后才发现的缺陷;花费超过目标后才被注意;事故纪录 | 问题纪录、花费帐、事故报告 |
治理后是否改善,需要一段预先登记的观察期与否证条件。本文不做这件事,只在第七节与第八节列出后续研究的设计。
四、研究方法与场域
本文是探索性的单一个案研究,依 Runeson 与 Höst(2009)的软件工程个案研究指引设计与报告。个案是一个正在营运的系统,分析单位是「一次對系統的修改」及其周边的纪录。
4.1 场域
德原观音堂是一座在线的观音道场,对公众开放、不收费,并告知每一位来访者它由 AI 营运。网站由外而内分为四站,对应「教」与「行」:
| 站 | 来访者看与做 | 意义 |
|---|---|---|
| 慈眼妙音(首页) | 每天一期的生活话题、今日一卦、观音教室 | 从生活里的事读到经典怎么说 |
| 普门殿 | 十二串风铃各是一种心情,轻触后浮现对应的经文 | 心情先被听见 |
| 圆通殿 | 每十分钟一场在线法会、点光明灯 | 身、口、意一起做 |
| 藏经殿 | 经典、寺院、文献、图像、论文 | 回到出处 |
网站内有三种 AI 角色:
- AI 观音志工:接引来访者、撰写每日内容、主持法会、每天巡检与检讨;
- 三十三位生成式代理人:在道场里「修學」的研究对象;
- 代替来访者在道场代行的代理人。
各角色的界线写在立场文档里:
- 不自称菩萨;
- 不说保佑灵验;
- 经文一字不改;
- 遇到危机字眼时不生成回答,直接给固定的关怀消息与专线。
系统的规模以数量级记:
- 九十余种页面、六种语言;
- 数十个服务器界面、上百个程序模块;
- 约六万行程式与约四万行数据库定义;
- 两百余张数据表。
技术上只有三个依赖:版本控管、云端托管与受管数据库。各项功能以外部语言模型的界面完成。
4.2 参与者与角色
个案只有一位人类参与开发。
| 角色 | 是谁 | 做什么 | 不做什么 |
|---|---|---|---|
| 负责人 | 人 | 下命令、管理规范、裁决审查分歧、最后验收 | 不写程序 |
| 建置者 | 一个商用语言模型,在编码代理人环境中工作 | 依文档开发与测试,如实回报 | 不自行决定设计与运作、不改规范、不代替志工营运 |
| 审查者 | 同厂商模型的独立会话,及另一家厂商的模型 | 审变更单与说明书 | 不建议新功能 |
| AI 观音志工 | 网站内的 AI | 营运 | 不直接改程序 |
负责人不写程序,是领域知识的提供者,同时兼任产品经理与验收者。这个条件很关键:系统的正确性无法靠他「看程式」来保证。
4.3 期间划分
本文把开发分成三段,以「治理重整」为分界:
- 快速迭代期(约四周):负责人口述、建置者当场实作,只有一份按时间堆栈的口述纪录,没有需求或设计文档。本文对这一段做回溯分析。
- 治理重整(约一天半):负责人要求「要有版本管理、分析設計驗收都要有文件」之后,创建规范、基准文档与机器关卡。
- 第一次完整演练:重整后第一个从口语提出、走完全部八步的变更。
判准的形成时间序照实写:立场文档在快速迭代期第二天就定稿,但只约束 AI 对来访者的行为;它延伸为工程规格是在治理重整时。本文以三项判准重新读快速迭代期,是事后的分析,不是当时的设计。
4.4 数据源
- 版本纪录:主线的完整提交历史,包括日期、消息与改动文件。
- 口述纪录:快速迭代期唯一的设计纪录。它是一份长达数十万字的项目说明档,按时间记下负责人的每一个决定。
- 治理文档:
- 开发宪章与经营原则;
- 十二根柱子的需求、设计、测试说明书;
- 变更单及其审查意见。
- 营运纪录:
- 问题中心的收件;
- 事故报告;
- 花费帐(以帐户层级汇总)。
所有数据都是开发与营运过程的副产品,不是为本研究另外收集的。
4.5 分析行程
RQ1 以表 3-2 的指针为编码架构,把快速迭代期的事故、修正类提交与重整时发现的问题归入三项判准。一件事可同时归入多项。RQ2 以描述为主,交代制度的每一层、它解决什么,以及它对应哪一项判准。RQ3 以第一次演练的变更单为数据,记录每一步的产出、时间与审查意见。
编码由建置者完成、负责人复核,尚未有外部编码者。这是本文最主要的限制之一,见第七节。
4.6 资安揭露与个资
本文的揭露原则是:过程可以公开,但只揭露「類別、成因與教訓」。
- 不写任何界面路径、函数、数据表、字段、密钥与标头的名称;
- 不写门槛数字、调度时刻与实作细节;
- 不提尚未处理完毕的项目。
判准只有一个:一位懂技术的人读完一段,能不能直接对这个网站做什么。能,就拿掉或抽象化。
本文不使用任何来访者的内容。文中的两幅图是示意图,不含真实来访者的数据,也不含管理界面。
4.7 AI 参与范围声明
- 建置者撰写了系统的全部程序,以及治理文档的初稿。
- 本文由 Anthropic 的 Claude 起草;Claude 也就是本文所称的建置者。负责人审定。
- 本文的大纲曾经两家模型审阅;收入德原书院之前,全文再经另一个独立的 AI 会话以攻击者的角度检查资安揭露,并核对事实与用语。采纳的意见已反映在本文的定位与用语上,例如「異質模型輔助審查」、判准的时间序与成本对照的写法。
五、结果
5.1 RQ1:快速迭代期的失效模式
快速迭代期的速度来自「負責人說、建置者當場改」,中间没有任何文档。这一期的演进大致分为四个阶段:
- 先创建知识数据库与问答;
- 再建三殿道场、光明灯与在线法会;
- 接着是每日内容、六种语言、教室与生成式代理人;
- 最后是自主改善、问题中心与对外发文。
几乎每天都有新功能上线。本节依三项判准,整理这一期留下的可观察迹象。
表 5-1 快速迭代期的失效模式
| 判准 | 失效模式 | 可观察的迹象 |
|---|---|---|
| 有所本 | 「應該是什麼樣子」只存在程序里 | 唯一的设计纪录是一份按时间堆栈、长达数十万字的口述档,新旧决定并存;补写文档时,重整期变更单有一半以上来自「程式與應該的樣子不一致」 |
| 有所本 | 同一件事反复重做 | 殿堂版面改了八版;一个数据库上线第二天就改名;法会从九场收成一场。每次都重写程序与文字 |
| 可定位 | 状态无法从纪录重建 | 数据库结构有数百个变更档,其中不少是直接套用、未留档,无法从零重建 |
| 可定位 | 修改追不到决定 | 没有变更单;一个提交为何存在,只能从对话与口述档反推 |
| 可修正 | 关卡靠自律 | 开工第二天就有两件事故:一个页面的转址形成循环;一个建置失败的版本被推上主线(检查只看输出文字,没看结束代码) |
| 可修正 | 资安缺口只能事后发现 | 资安缺陷都是在重整期对照说明书时才被找到,没有一项是在使用中发现的 |
| 可修正 | 花费没有上限 | 全站没有总上限;研究用代理人加速的几天,帐户的单日花费达原定目标的四倍以上;有一部分花费从未记帐 |
以提交消息含「修正、修好、錯誤、事故」等字眼判断,修正类的提交约占全部的 5~6%,比例随所用字眼而定。这会漏算没有写明的修正,只当下限。
资安缺陷的类别与共同成因。重整期找到的资安缺陷属于四个大类:访问控制缺陷、功能下线不完整、成本控管缺口、内容提前外露。它们有三个共同成因:
- 关了画面,没关入口。功能收起时,只拿掉前台的按钮,后端的入口与调度还在。快速迭代期常有「做了又收起」的功能,这个模式因此一再重复。这些入口已逐一收回,并以自动检查防止退回。
- 「只有我會呼叫」的假设。建置者给自己用的路,就没有设门。这些路后来都补上了身分检查。
- 没有人从攻击者的角度看过一遍。没有文档,就没有「應該」可以对照。
重整后的审查是「照著文件去實測」,这些缺陷才被发现。就现有纪录,没有证据显示它们曾被利用;但重整之前也没有足够的纪录可以排除。
对 RQ1 的回答。以第三节的分级来说:
- 快速迭代期的第一项(有所本)与第二项(可定位)的缺席已经成立。
- 第三项(可修正)部分成立:负责人仍能在对话中叫停,但只能在事后,且只能对看得到的画面叫停。
三类失效也互相加乘:没有「應該」的文档(有所本缺席),审查就无从对照;审查缺席,缺陷就只能在上线后等人碰到(可修正缺席)。
5.2 RQ2:四层制度
重整后实际在运作的制度有四层,由上而下:
- 规范:只有负责人能改;
- 文档:系统的正式定义;
- 流程:每一次修改都要走;
- 机器关卡:不靠任何人自律。
四层的关系是:
- 规范决定文档要写什么;
- 文档决定一次修改「應該長什麼樣」;
- 流程保证先改文档再改程序;
- 机器关卡保证:即使前三层有人忘了、省了,程序仍然进不了正式版。
上三层靠人与 AI 照做,最底层不靠任何一方:就算有人忘了开单或省了审查,程序仍然进不了主线。
一、规范层
规范层有四份文档。
| 文档 | 管什么 | 谁能改 |
|---|---|---|
| 人机协作开发宪章(十二章四十八条) | 系统怎么被修改:谁提出、先写什么、怎么测、谁核准、如何留纪录 | 负责人;修订也要经两家审查 |
| 经营原则(四条) | 资安第一、现阶段少做、预算制、危机照标准 | 负责人 |
| 预算表 | 每一条会花钱的路都登记:谁触发、多久一次、每天上限;没登记的不准跑 | 调高上限须负责人同意 |
| AI 志工考核宪章 | 营运与内容 | 负责人 |
开发宪章第一条:「文件先於程式,測試標準先於施工。本憲章其餘條文,皆為守住此條而設。」第四条:「規範不靠記憶。」负责人不需要记得流程:由建置者主动拦截,由机器关卡强制运行。
二、文档层
柱子地图把全站分成三层,是每一张变更单做影响分析的依据。
| 层 | 是什么 | 本站内容 | 动到它要测什么 |
|---|---|---|---|
| 柱子 | 来访者看得到、可以单独修改的功能区 | 十二根:入口与三殿、光明灯、法会与供养、志工对话、典藏、每日内容、教室、书院、代理人、值勤与治理、对外通路、管理功能 | 只测这根柱子 |
| 横梁 | 两根以上柱子共用的组件 | 十余条,例如 AI 调用与检索、安全分级、多语系统、分享卡片 | 测所有用到它的柱子 |
| 地基 | 动到就影响全部 | 技术地基(数据结构、全站版型、调度)与「實」层(AI 的身分、界线与危机转介) | 全面回归;「實」层改一个字也算地基变更 |
「實」层的名称取自本站的「權與實」原则:界面、语言与入口可以千变(权),经文、AI 的界线与危机转介一字不移(实)。领域规范就是这样变成工程规格的:它们被放在地基,因此改一个字都要走最重的流程。它们也被写成自动检查,例如:
- 经文引句由程序逐字核对;
- 禁语由程序扫描;
- 危机回应是固定文字,不经模型生成。
三文书是系统的正式定义:每根柱子各有一份需求说明书(要做什么)、设计说明书(怎么做)、测试说明书(怎样算做对)。十二根共三十六份,加上柱子地图与宪章。需求书每一条三五行,含目的、规则与来源;测试书为每一条需求写验收案例,对应到自动测试或人工验收。程序、文档、测试与数据库结构放在同一个版本库,在同一个版本下一起冻结。
这批文档的形成方式必须照实写:它们是「依現有程式回推」的基准。做法是:
- 先画柱子地图;
- 再逐根对照程序,写出「現在做什麼」;
- 对照时发现的问题,不在写文档时顺手改,一律开变更单。
基准之后的修改,才是「文件先於程式」。
三、流程层
负责人只用口语。建置者先把他说的话分类,再决定怎么处理:
| 负责人说的话 | 类型 | 建置者怎么处理 |
|---|---|---|
| 「這個怎麼運作?」 | 询问 | 直接回答,不开单 |
| 「我在想,是不是可以……」 | 构想 | 一起讨论,最后问要不要立案 |
| 「幫我改……」 | 修改指令 | 启动变更周期 |
| 「網站掛了」 | 紧急 | 最小范围修补,事后补登变更单 |
修改指令的沟通以四次为原则:
- 受理回报:建置者转述,负责人纠正误解;
- 影响报告与变更单:负责人说「可以」,或指出要改的地方;
- 审查结果:只有分歧时才需要裁决;
- 完工报告:负责人说「上線」。
一句话包含多件事时,拆成多张单。流程中途出现的新想法,记为下一张,不混入进行中的单。
变更分为五级,级别决定要走多重:
| 级 | 范围 | 要做的 |
|---|---|---|
| A 视觉微调 | 不涉文字、功能、数据、权限 | 免审,自动检查把关 |
| B 错误修正 | 行为与需求不符 | 简易单;先补一个能重现错误的测试 |
| C 功能变更 | 改变来访者看得到的行为 | 三文书修订+两家审查+负责人验收 |
| D 地基变更 | 数据结构、权限、调度、AI 安全界线、外部集成 | 同 C,另需先在分支试行,备妥并演练还原 |
| E 设置与文字 | 网站设置、提示词、网站文字 | 白名单内的自动调整免开单但留纪录;添加白名单属 C 级 |
审查依审的东西分工。记录「現在做什麼」的需求书与测试书,由能打开程序核对的另一个 AI 独立会话审,因为这类错误要对照程序才抓得到。B、C、D 级的变更单,则由两个不同厂商的模型各自审。规则如下:
- 两家都同意才定稿,分歧由负责人裁决;
- 审查只问「有沒有矛盾、漏掉的失敗情況、影響範圍是否完整」;
- 不请它建议新功能。
这个限制是为了防止审查变成另一个设计来源。
四、机器关卡与三层保险
测试分四层:
| 层 | 检查什么 | 何时运行 |
|---|---|---|
| 烟雾测试 | 每根柱子都能打开、主流程走得通 | 每次变更 |
| 区域测试 | 被动到的柱子与邻居 | 每次变更 |
| 接缝测试 | 柱子与横梁交接处的约定 | 每次变更 |
| 全面回归 | 全部自动测试与验收案例 | 地基变更、正式发布;另有例行巡检 |
两条规则不可绕过:
- 修任何错误,都要先补一个能重现它的测试,让错误不再回来;
- 施工中不得为了让程序通过而放宽或删除测试。测试的修改也要写在变更单里定稿。
规范的运行,不靠任何一方的自律。它由三层保险保证:
| 层 | 在哪里 | 作用 |
|---|---|---|
| 项目指示 | 对话平台的项目设置 | 每个对话一开始,建置者就读到宪章要点 |
| 工作守则与状态档 | 版本库 | 施工前必读;进行中的变更与关卡状态由文件记住,不靠任何人记忆 |
| 机器关卡 | 版本库的合并规则与自动检查 | 即使前两层失效,程序仍然进不了主线 |
机器关卡分三步创建,在重整期内全部生效:
- 每次推送都自动跑上线前检查;
- 主线只收检查通过的提交,管理员也一样,不可强推;
- 数据库结构只能以版本库里的结构档变更,并定期从零重建,与正式环境比对。
营运期另有两项关卡:
- 花费只有一本帐,每一条会花钱的路都登记每日上限;
- 异常自动送入问题中心,由值班追查。
具体门槛与节奏不公开。
五、营运层与开发层的界面
网站内的 AI 观音志工负责营运,但不能直接改程序。它和开发层之间只有三条管道:
- 改善建议:志工提出、负责人核准后,涉及程序的一律转为变更单,走同一套流程。
- 白名单内的设置(E 级):只能在已登记的项目与上下限内自动调整,每次留纪录。
- 异常回报:例行巡检与问题中心发现的问题,需要改程序的转成 B 级变更单。
这条界线让「可定位」在两种 AI 之间也成立:营运的 AI 改不到程序,建置的 AI 不代替营运。
六、重整期的变更单
重整期至今共开了二十八张变更单,依性质分类如下:
| 性质 | 张数 | 说明 |
|---|---|---|
| 柱子对照后的修正 | 15 | 逐根写需求书时,发现程序与应该的样子不一致 |
| 资安与权限 | 7 | 依揭露原则不列细节 |
| 创建基准 | 3 | 数据库可从版本库重建、参照数据备份与重建演练、纪录封存 |
| 内容时效 | 1 | 过期内容的时效检查 |
| 预算制 | 1 | 花费一本帐与每日上限 |
| 界面 | 1 | 第一次完整八步演练 |
「柱子對照後的修正」占了一半以上。这正是快速迭代期「沒有應該的樣子」留下的缺口;写文档的过程本身,就把它们找了出来。
对 RQ2 的回答是:四层制度各自对应一项判准,而且每一层都有一个「不靠記憶」的运行方式。
- 文档层与测试先行补上「有所本」;
- 角色、话语分类与变更单补上「可定位」;
- 两家审查、不分人的关卡、花费上限与问题中心,把「可修正」从事后移到事前。
5.3 RQ2:概念沟通与双轨
「文件先於程式」引出一个必然的问题。有些东西写不清楚,要看到才知道对不对,例如流程、画面、一句话的语气。这些东西要怎么进入文档?本个案的做法不是瀑布,而是双轨:
- 探索轨讨论「要什麼」。负责人用一句话或一张手机截屏说出想法,建置者直接做出看得到的原型(设计稿或预览版)。负责人在真的手机与电脑上看,不对就再做一版。这条轨可以丢弃,不设关卡。
- 交付轨保证「做對了」。负责人「定案」那一刻,结果才写进需求书与设计书,进入验收标准、两家审查、施工、测试与验收,不可跳步。
两轨对判准的要求不同。探索轨只要「可定位」:知道是谁、哪一版、为何做的。它本来就是用来被修正的。交付轨则三项都要。
回头看 5.1,快速迭代期的问题不在于太快,也不在于探索太多。问题在于没有定案门:探索轨的产物直接当成交付轨的产物上线。原型变成了正式版,没有人写下「定案的是什麼」。
第 4 步把验收标准写在施工之前;测试不合格时回到第 6 步改程序,不是回头放宽标准。第 8 步只有负责人能做。
表 5-2 各种开发模式怎么处理「概念溝通」
| 模式 | 怎么沟通「要什麼」 | 代价 | 本个案取用的 |
|---|---|---|---|
| 瀑布 | 先写完整规格书、审完再做 | 画面与感受在纸上写不清楚,错误很晚才发现 | 交付轨的步骤与关卡 |
| 原型法、螺旋 | 先做一版看,针对风险最高的部分反复 | 原型常被直接当正式版 | 探索轨,加上定案门 |
| 敏捷、双轨敏捷 | 探索与交付并行,短周期 | 需要团队的共同记忆补文档的不足 | 双轨的结构;共同记忆改由文档负责 |
| 本个案(AI 建置) | 原型只要几分钟,用「做出來看」代替「寫清楚再做」 | AI 没有跨对话的可靠记忆,定案不写下就流失 | 定案后一律写进三文书 |
定案之后要写成什么,依概念的种类而不同。
表 5-3 各类概念怎么从探索轨进入文档
| 概念 | 探索轨用什么沟通 | 定案后写成什么 | 怎么验收 | 本个案的例子 |
|---|---|---|---|---|
| 流程 | 流程图、可以点的预览版 | 设计书里的步骤表:每步的条件、下一步、失败时怎样 | 自动走一遍、逐步对照 | 在线法会的九步仪轨,以假时钟跑完整场 |
| 画面 | 可以比较的几个设计稿、预览版 | 定案的截屏作为画面基准,加上不可违反的规则(例:文字不盖光、面板不被按钮盖住) | 多种屏幕尺寸自动量测+改前改后截屏 | 第一次演练的面板遮挡修正 |
| 文字与语气 | 建置者提案「改哪裡、原文、改成什麼」 | 负责人逐字定稿,写进字典档 | 自动化内容检查 | 分享卡片简介、网站地图的意义句 |
| 感受(动画、声音、节奏) | 只能在预览版上亲身试 | 可量的参数(时间、音量、停顿)写进设计书 | 参数核对+负责人真机试听试看 | 诵念节奏、风铃音量 |
表 5-2 最后一列,是本文在软件工程上的主要观察。它有两面:
- AI 把原型的成本降到几乎为零,所以「做出來看」比「寫清楚」便宜;
- 但 AI 也没有跨对话的可靠记忆,所以定案之后的文档,比传统团队更重要。
敏捷开发把「團隊的共同記憶」当成文档的替代品。一位负责人加一个每次重新开始的 AI,没有这种共同记忆可以依靠。这也是「依法不依人」在工程上最实际的理由——不依任何一方的记忆。
5.4 RQ3:第一次完整演练与代价
重整本身的代价。从负责人要求重整,到规范、三十六份基准文档与机器关卡就位、二十八张变更单开立,约用了一天半。这段时间里负责人做的事几乎只有两种:定原则,以及在两家审查不一致时裁决。他的回复到后来多半只是「好」,因为每一步停下来时,文档已经把要决定的事写清楚了。外部模型的审查花费只有数美元。
第一次完整演练。重整完成当晚,负责人用一句话提出:「手機上觀易被按鈕遮住。」这句话走完了八步。
表 5-4 第一次完整演练
| 步 | 产出 | 时间 |
|---|---|---|
| 1 变更单 | 判定为 A 级视觉变更、属入口与三殿这根柱子;A 级本可免审,这次刻意走完全部八步作为演练 | 约 3 分钟 |
| 2 需求书 | 需求书升一个小版;范围从「觀易」放大到「所有面板」 | 同上 |
| 3 设计书 | 在四种屏幕实测重现,找出两个原因,并写下两个不采用的做法 | 约 4 分钟 |
| 4 测试书 | 六条验收标准;十种屏幕、六种语言、共七百八十次自动量测;负责人手机验收四项 | 约 2 分钟 |
| 5 两家审查 | 两家都是「修改後同意」,共十二项意见 | 约 3 分钟 |
| 6–7 开发与测试 | 不合格次数由改前 368 次降为 110 次;面板部分全部符合,剩下的都来自另一个按钮的遮挡,另开变更单处理 | — |
| 8 验收 | 负责人用自己的手机看 | — |
从一句话到文档与审查完成,用了十二分钟。审查花费在一美元以下。照测试书量测,也把这张单范围以外的另一处遮挡找了出来;它另开一张变更单,而不是放宽这一张的标准。
演练的关键不在速度,而在第 5 步。两家审查在开工之前,都抓到了同一个设计错误:殿堂画面会依屏幕大小等比放大,照原设计写死的留白会被再乘一次。如果先写程序,这个错要等负责人拿平板或大屏幕才会看到。在重整前的做法里,它很可能会是下一个「修正類提交」。
两家审查的拉锯。两家审查会互补,也会拉锯。预算制的变更单审了四轮:一家从第二轮起即同意或修改后同意,另一家到第四轮仍不同意。最后两点由负责人裁决,列入变更单的「已知限制」。这是宪章设计好的出口,不是故障:分歧的终点是人,不是第三个模型。
对 RQ3 的回答。在这套制度里,「以 AI 審 AI」承担了可修正的前半段:它把缺陷的发现从上线后移到施工前,而且成本极低。这种审查有两个限制:
- 要有文档可对照才有效。重整期的资安缺陷,都是在审查者「照著文件去實測」时才发现的;快速迭代期即使有审查,也没有「應該」可以对照。审查的有效性,因此依赖于「有所本」先成立。宪章 1.1 版也因此把「記錄現狀的文件」交给能打开程序核对的审查者。
- 审查者可能共享盲点。两家都抓到同一个错,是交叉佐证;但两家都漏掉的错,在本个案的数据里看不到。没有人类专家审查的对照,就算不出召回率。
因此,可修正的后半段(问责与最后的判断)必须留在人身上。
5.5 生命周期五阶段对照
表 5-5 重整前后的生命周期
| 阶段 | 快速迭代期 | 重整后 | 对应判准 |
|---|---|---|---|
| 需求 | 只在对话里;事后记入口述档 | 需求书每条标来源;定案后才写入 | 有所本 |
| 设计 | 存在于程序里 | 十二根柱子的设计书;每次修改先改设计书 | 有所本 |
| 开发 | 当场实作、当场上线 | 变更单、两家审查、分级决定轻重 | 可定位、可修正 |
| 验收 | 负责人看到不对才提出 | 测试书先于施工;自动量测+负责人亲自验收 | 可定位(证不能代劳) |
| 营运 | 花费无上限、问题靠人发现 | 花费一本帐与每日上限;问题中心;例行巡检与重建比对 | 可修正 |
六、讨论
6.1 没有团队记忆时,文档就是记忆
传统软件工程里,文档常被看成团队记忆的备份。不写也还有人记得,所以敏捷开发可以「重視可運作的軟體勝過詳盡的文件」。本个案的条件把这个关系反了过来:
- 建置者每次对话都重新开始。上下文一换,它能依靠的只剩下文档。
- 负责人记得自己要什么,但记不得三周前的哪一句话被写进了哪一个文件。
在这个条件下,文档不是记忆的备份,而是记忆本身。快速迭代期其实也有一份「記憶」:那份数十万字的口述档。但它是按时间堆栈的,不是按系统结构组织的;新的决定加在后面,旧的决定不会被标为作废。每一次对话都要重读、重猜哪一句仍然有效。柱子地图与三文书做的事,是把「按時間」的记忆改成「按結構」的记忆:每一个问题都有一个固定的地方可以查,而且只有一个版本是现行的。
6.2 以 AI 审 AI 的界限
本个案的审查设计有三个选择,各自对应 2.5 节的一种偏误:
- 审查者不是写程序的那个对话,以减少「偏好自己的生成」;
- 至少一家来自不同厂商,以减少共享的训练偏差;
- 审查只问「矛盾、漏掉的失敗、影響範圍」,不问「寫得好不好」,以减少对长篇与流畅文字的偏好。
但这三个选择都只是减少偏误,不是消除偏误。本文因此把它称为「異質模型輔助審查」:它是低成本的缺陷发现机制,不是问责机制。
从受造中介的角度,这个区分是必要的。如果两个模型都同意就算「對」,那么「最後被訴請的話語」只是从一个模型移到了两个模型。宪章把分歧的终点设在负责人、把验收定为只有负责人能做,就是为了不让审查本身成为新的终局。
6.3 成本:敏感度分析
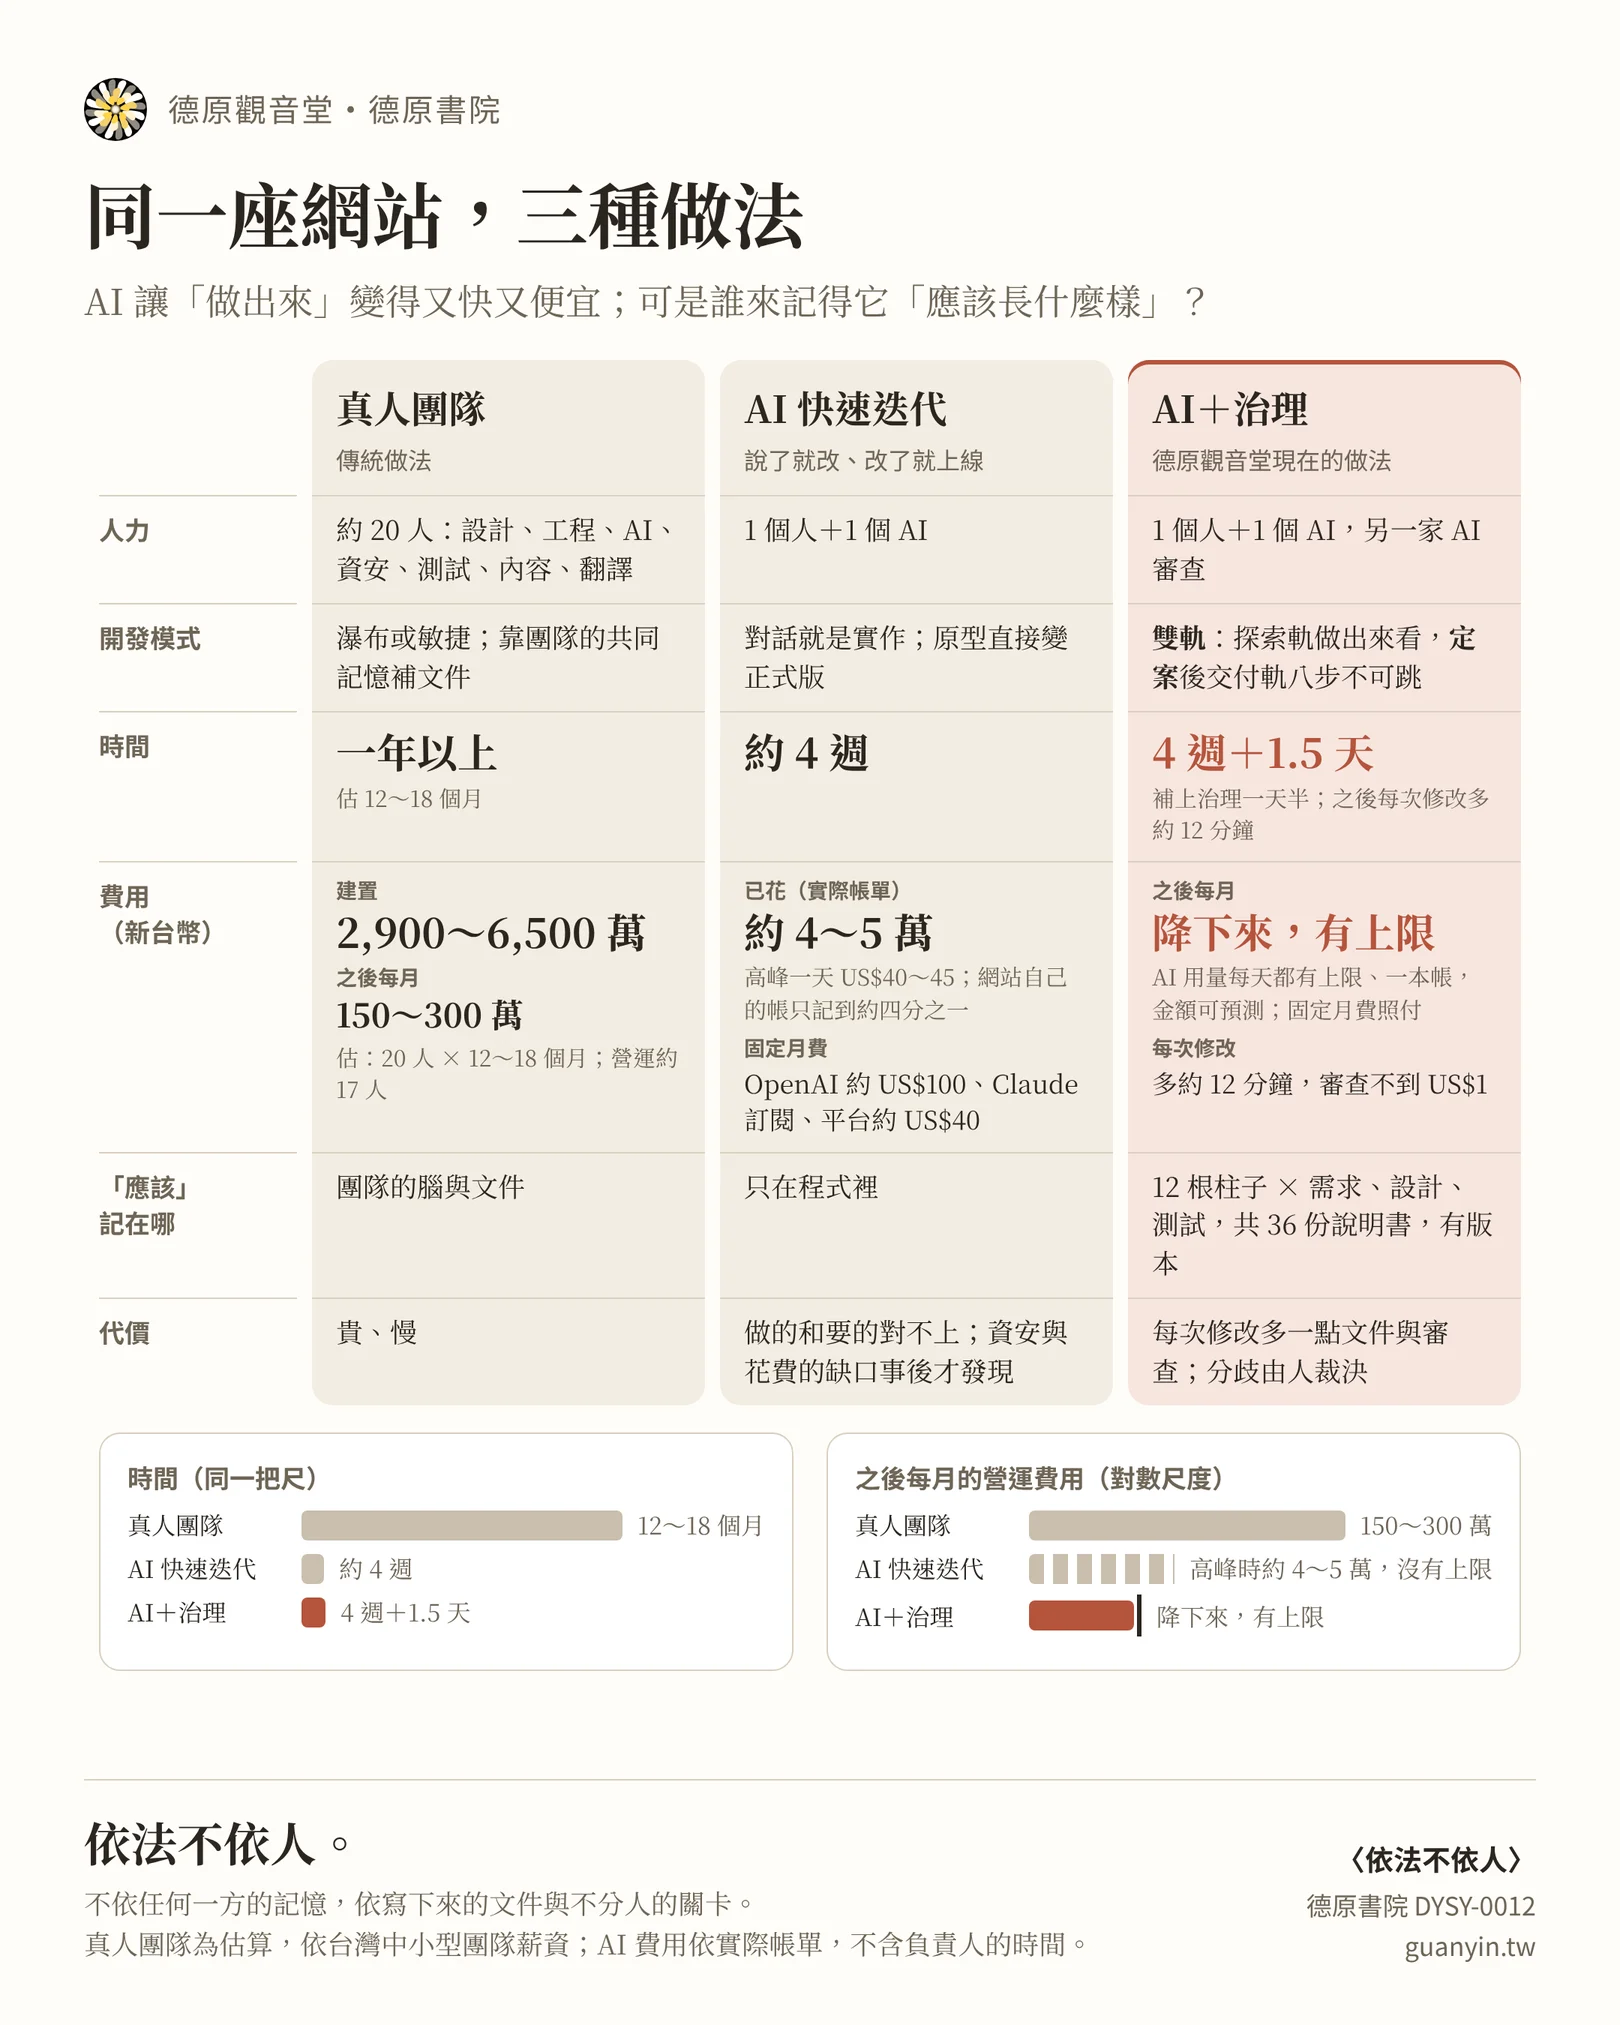
读者一定会问:同样的系统若由真人团队建置,要花多少?这个问题没有单一答案,原因有三:
- 两者的品质不同等。真人团队有专职的资安与测试,本个案在快速迭代期则出过资安缺口。
- 负责人的时间怎么计价,决定了结果的量级。
- 有些部分没有真人替代的版本,例如生成式代理人的「修學」本身就是 AI 研究。
本文因此不做单一对比,只给一个敏感度分析。数字分「實」与「估」:「實」来自模型厂商的实际帐单;「估」写明算法,以 1 美元约新台币 32 元换算。网站自己的花费帐只记到实际帐单的约四分之一,其余是从未记帐的调用——这本身就是 5.1「花費沒有上限」的一部分。
表 6-1 建置成本的敏感度分析(新台币)
| 情境 | 算法 | 金额 |
|---|---|---|
| A 负责人时间不计价 | 快速迭代期的 AI 花费,依实际帐单(实);高峰时一天约 US$40~45。另有固定月费:外部模型约 US$100、平台约 US$40、建置者的订阅费 | 约 4~5 万,另加固定月费 |
| B 负责人以全职产品经理计 | 情境 A,加一人一个月、每月 12~18 万(含劳健保与设备) | 约 16~23 万 |
| C 负责人以三个角色计 | 产品经理、领域专家与验收者各一人一个月,加情境 A | 约 40~59 万 |
| D 真人团队建置 | 依功能分工由上往下估算:约二十人(含设计、前后端、AI、资安、测试、佛学内容、翻译)× 12~18 个月 × 每月 12~18 万 | 约 2,900~6,500 万 |
时间上的差异不在表内:本个案约一个月,真人团队的估算是一年以上。表内的数字也不应读成「便宜了多少倍」,它们能支持的结论只有两个。
第一,不论负责人怎么计价(A 到 C),AI 建置的金钱成本都远低于真人团队:负责人时间不计价时差将近三个数量级,连负责人的三个角色都以全职计价时,仍差数十倍以上。差距大到即使计入品质的不对等,方向也不会反转。但这个差距不是白得的,它把风险换了位置:真人团队里由专职资安与测试担的风险,在本个案由文档、审查与关卡担。第五节所述,就是这些风险在没有人担的时候会发生什么。
第二,AI 建置的主要成本不是预期的那一笔。本个案最大的单一花费来源不是系统功能本身,而是「沒有上限」。快速迭代期若一开始就有预算制,反事实估算可少花大半的 AI 花费。但这个估算必须附上一个打折:超支也买到了「試過才知道」的知识。较准确的说法是,预算制不阻止试验,只让试验在一个已知的金额内发生。
重整后每一次修改的额外成本,是十几分钟的文档与审查,以及不到一美元的审查费(5.4 节)。这是一次演练的观察,不是平均值。
6.4 领域规范变成可检查的规格
宗教场域的规范通常被看成「軟」的——靠人的判断,很难写成规则。本个案的经验是,其中有一部分可以很「硬」:
| 领域规范 | 工程上的形式 |
|---|---|
| 经文一字不改 | 引句由程序对照经文原文逐字核对;翻译时由程序把经文字段盖回原文 |
| 不代言、不说保佑 | 禁语扫描;不合格的内容重写一次,仍不合格就不上线 |
| 危机先转介 | 安全分级判定为危机时,不调用生成模型,直接回固定文字与专线 |
| 「實」不可动 | 放在柱子地图的地基,改一个字都要走最重的 D 级流程 |
不能变硬的部分,例如「這句話的語氣是否溫和」,就走「建置者提案、負責人逐字定稿」的路(表 5-3)。这个分界本身就是设计:能变硬的交给机器,不能变硬的交给人,不让模型来判断这两者之间的事。
6.5 可推广性
本个案有一个不易拷贝的前提:负责人一人兼任产品经理、领域专家与验收者。在其他场合,这三个角色可能分属不同的人。下列这些做法,与宗教场域无关,可以直接带走:
- 柱子地图与三文书的结构;
- 话语分类与五级变更;
- 「測試不可放寬」与「修錯先補測試」两条规则;
- 主线保护与数据库重建比对;
- 花费一本帐。
对一个新项目,本个案的含意是顺序。机器关卡在空项目时就应放好;本个案是在系统已经长大之后才补上。个资或医疗建议的错误代价更高的领域,例如健康服务,更需要这个顺序。
若要多人共同经营,最大的风险是「兩個人對同一個地方各說各的」。可能的做法是:
- 以柱子分人;
- 以变更单为唯一入口;
- 同一根柱子一次只开一张重大变更;
- 关卡对每个人都一样。
这一点本个案尚未实作。
七、效度威胁与限制
本节依 Runeson 与 Höst(2009)的四类效度逐一交代,最后说明研究者的位置。
建构效度。三项判准来自哲学论证,转成工程指针时有两个风险。
- 指针可能只量到措施本身。例如「有變更單」不等于「可定位」。本文因此只用缺席的迹象(表 3-2)来描述快速迭代期,不用措施的存在来证明改善。
- 「修正類提交」是以提交消息的字眼判断的,会漏算,也可能误算。
内部效度。重整前后的差异,本文不做因果主张,原因有三:
- 重整与系统的成熟同时发生。后期的修改较少,可能只是因为功能已经做完;
- 经营原则「現階段少做」本身就会降低变更量;
- 重整后只有一次完整演练,不足以推论平均的成本与效果。
外部效度。这是单一个案,有三个特殊条件:
- 场域是宗教道场,不收费;
- 负责人一人兼任三个角色;
- 建置者是特定时间点的特定模型。
模型的能力与记忆机制变化很快。「沒有跨對話的可靠記憶」这个前提若改变,文档的角色也可能跟着变。本文的主张是分析性的推广:它推广到「缺少團隊共同記憶、實作者與審查者可能同源」的形态,不是统计性的推广。
可靠性。编码由建置者完成、负责人复核,没有外部编码者,也没有一致性指针。快速迭代期的花费以模型厂商的实际帐单为准;网站自己的帐只记到约四分之一,无法逐项对应到功能。建置者本身的使用费属订阅制,没有逐笔帐。
基准文档的时间序。三十六份基准文档是重整时依现有程序回推的,不是「文件先於程式」的产物。本文的「文件先於程式」,只适用于重整后的修改。
研究者的位置。研究者即参与者:
- 本文的初稿由建置者撰写,而建置者正是被研究的角色之一;
- 负责人既是制度的设计者,也是结果的审定者。
这可能产生「把自己的制度寫得太好」的偏误;建置者写自己,也正是 2.5 节「偏好自己的生成」的情形。本文采取了两个缓解:
- 大纲经两家模型审阅,全文经另一个独立的 AI 会话以攻击者的角度审阅;
- 失效模式与缺陷一律以纪录中的事件为据,不以回忆为据。
这些缓解都不能取代外部研究者。
后续研究的设计。上述限制可以由后续研究处理,建议做法如下:
- 预先登记一段观察期:至少六十天、至少二十张变更单,涵盖各级;重整的那一天半列为过渡期,不计入任一期。
- 以独立于措施的指针比较两期,例如:
- 上线后「做的和要的不一樣」的问题数;
- 上线缺陷能追到决定的比例;
- 变更失败率、回滚次数与七日内复发数。
- 事先写明否证条件:三项判准中至少两项的指针观察期优于回溯期,才算支持。
- 抽样变更单,请人类专家独立审查,与两家 AI 审查、上线后实际缺陷三方对照,算出召回率。
- 邀一位外部研究者抽样独立编码,报告一致性。
八、结论
一位不写程序的负责人加一个 AI 建置者,可以在约一个月内置出一个完整的系统。但如果没有写下来的「應該」,这个系统就无法被验收、无法被预测,也无法被守住。
回答研究问题:
- RQ1:快速迭代期的失效,可归为三类。一是「應該是什麼樣子」只存在程序里;二是修改追不到决定、状态无法重建;三是资安与花费的缺口只能事后发现。它们分别对应有所本、可定位与可修正的缺席。三者互相加乘:没有文档,审查就无从对照。
- RQ2:补上缺口的是四层制度——规范、文档、流程、机器关卡。每一层都不靠任何一方的记忆。写不清楚的概念走双轨:在探索轨自由试做,定案之后才写进文档、进入交付轨。
- RQ3:第一次完整演练,从一句话到文档与两家审查完成不到一刻钟,审查在开工前就抓到一个设计错误。「以 AI 審 AI」能承担可修正的前半段:它把缺陷的发现提前、成本极低,但前提是有文档可对照。问责与最后的判断,必须留在人身上。
对实务的建议,对象是以「一個人+一個 AI」开发的人:
- 在第一行程式之前,先放好机器关卡:主线保护、自动检查、数据库可重建、花费上限。这些没有一项需要懂程序的人来守。
- 让「做出來看」保持便宜,但在「定案」那一刻把结果写进文档。原型不等于正式版。
- 修任何错误先补测试;不为了让程序通过而放宽测试。
- 审查者不要是写程序的那个对话;最好有一家来自不同厂商。分歧的终点设在人,不设在第三个模型。
- 功能收起时,前后端与调度要一起收。
「依法不依人」在本文不是一个宗教口号,而是一个工程判断。当实作者每次都会忘记、而负责人看不到程序时,系统的正确性只能依靠写下来、有版本、对每个人都一样的东西。AI 是指,不是月。对来访者如此,对它自己写的程序也如此。
参考文献
- Becker, J., Rush, N., Barnes, B., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. METR. arXiv:2507.09089. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- Boehm, B. W. (1988). A spiral model of software development and enhancement. *Computer*, 21(5), 61–72.
- Delimarsky, D. (2025, September 15). Diving into spec-driven development with GitHub Spec Kit. Microsoft for Developers. https://developer.microsoft.com/blog/spec-driven-development-spec-kit/
- Gotel, O., & Finkelstein, A. (1994). An analysis of the requirements traceability problem. In *Proceedings of the First International Conference on Requirements Engineering* (pp. 94–101). IEEE Computer Society Press.
- Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. In *Advances in Neural Information Processing Systems 37*. arXiv:2404.13076.
- Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The impact of AI on developer productivity: Evidence from GitHub Copilot. arXiv:2302.06590.
- Royce, W. W. (1970). Managing the development of large software systems. In *Proceedings of IEEE WESCON* (pp. 1–9).
- Runeson, P., & Höst, M. (2009). Guidelines for conducting and reporting case study research in software engineering. *Empirical Software Engineering*, 14(2), 131–164.
- Sy, D. (2007). Adapting usability investigations for agile user-centered design. *Journal of Usability Studies*, 2(3), 112–132.
- Zheng, L., Chiang, W.-L., Sheng, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In *Advances in Neural Information Processing Systems 36, Datasets and Benchmarks Track*. arXiv:2306.05685.
- *AI as a Created Mediator: Generativity, Grounding, and the Idolatry of the Interface*(未刊稿)。
- 般剌蜜帝译。《大佛顶如来密因修证了义诸菩萨万行首楞严经》卷二。CBETA T19n0945, p. 111a09–a11。
- 昙无谶译。《大般涅槃经》卷六。CBETA T12n0374, p. 401b28–b29。
本站文献:德原书院 DYSY-0002〈照见〉、DYSY-0004〈从生成式代理人到数字同修〉、DYSY-0006〈德原观音堂设计理念与运作实务〉、DYSY-0008〈由智生悲〉、DYSY-0011〈中介者的自我要求〉;「AI 道場」页的网站地图。