 덕원관음당
초록
배경: AI 코딩 에이전트 덕분에 한 사람이 구어로 지휘하는 것만으로도 몇 주 안에 중대형 시스템을 구축할 수 있게 되었다. 그러나 소프트웨어 공학은 본래 팀의 공유된 기억과 분업으로 시스템이 '올바르게 만들어졌음'을 보장해 왔는데, 이러한 조건에서는 이 두 가지가 모두 존재하지 않는다.
목적: 본 논문은 덕원관음당을 사례로 삼아, '책임자 한 명+AI 구축자 하나'라는 조건에서 신속한 반복 개발이 어떤 실패 양식을 낳는지, 그리고 이러한 결함을 메우기 위해 어떤 소프트웨어 공학적 운영과 아키텍처를 세웠는지 탐구한다. 덕원관음당은 AI가 설계·개발·운영하는 온라인 관음 도량이다.
분석 틀: 철학에는 '피조된 중개'라는 논의가 있다. AI가 생성할 수 있다는 것이 곧 뿌리가 있다는 뜻은 아니며, 인터페이스가 궁극적 권위로 받아들여지는 것을 피하려면 중개가 세 가지 조건, 곧 근거가 있을 것·위치를 확인할 수 있을 것·수정할 수 있을 것을 유지해야 한다. 본 논문은 이 세 조건을 연구 동기와 분석 틀로 삼으며, 증명해야 할 명제로 다루지는 않는다.
방법: 탐색적 단일 사례 연구로, 자료는 신속한 반복 기간과 그 뒤에 이루어진 한 차례의 거버넌스 재정비에서 취했다. 신속한 반복 기간은 약 4주, 커밋은 천 건에 가깝고, 거버넌스 재정비는 약 하루 반이다. 자료에는 버전 기록, 변경서, 요구·설계·테스트 명세서, 문제 기록, 비용 장부가 포함된다. 신속한 반복 기간은 회고적 분석에 해당한다.
결과:
- 신속한 반복 기간의 실패는 세 유형으로 나뉘며, 각각 세 조건의 부재에 대응한다.
- 시스템이 '어떤 모습이어야 하는지'가 프로그램 안에만 존재했다(근거 부재).
- AI가 작성한 것이 곧 서비스에 올라갔으며, 수정 내용을 결정과 결정자까지 추적할 수 없었다(위치 확인 부재).
- 보안과 비용의 결함을 사후에야 발견할 수 있었다(수정 가능성의 부분적 부재).
- 재정비 후의 제도는 네 층으로 이루어진다. 규범, 문서, 절차, 기계적 관문이다.
- 문서는 열두 개의 '기둥'으로 조직되며, 각 기둥마다 요구, 설계, 테스트의 세 가지 명세서가 있다.
- B급 이상의 수정에는 모두 변경서를 열고, 서로 다른 두 업체의 모델이 검토한 뒤, 마지막으로 책임자가 검수한다.
- 메인 브랜치는 자동 검사를 통과한 커밋만 받는다.
- 문서를 보완하여 쓰는 과정 자체가 기존의 결함을 다수 찾아냈다. 재정비 기간의 변경서 가운데 절반 이상이 '프로그램이 응당 그래야 할 모습과 일치하지 않음'에서 비롯되었다. 첫 완전한 시연은 구어 한 문장으로 제기되어 십여 분 안에 문서와 두 곳의 검토를 마쳤고, 검토는 시공 전에 설계 오류 하나를 잡아냈다.
결론: AI는 시제품의 비용을 거의 0으로 낮추었고, 그 결과 '만들어서 보는 것'이 '분명하게 쓰는 것'보다 저렴해졌다. 그러나 AI에게는 대화를 넘나드는 신뢰할 만한 기억이 없으므로, 확정된 문서는 전통적인 팀에서보다 오히려 더 중요하다. 본 논문은 '이중 궤도' 방식을 제안한다. 탐색 궤도에서는 자유롭게 시도하고, 인도 궤도에서는 문서·검토·관문을 엄수하며, 두 궤도 사이에는 '확정'이 문 역할을 한다. 거버넌스 이후의 장기적 효과는 사전 등록된 지표로 검증하는 후속 연구에 맡긴다.
주제어: AI 보조 소프트웨어 개발, 사례 연구, 명세 우선, 변경 관리, 추적 가능성, LLM 검토, 이중 궤도 애자일
1. 서론
1.1 연기: 입장이 먼저이고, 프로그램은 나중이다
덕원관음당은 기술이 먼저 있고 그다음에 용도를 찾은 것이 아니다. 작업을 시작한 지 이틀째에 이미 글로 쓴 입장 확정본이 있었다. 이 대리인 기제 문서는 사이트 안의 AI가 “한 손가락일 뿐이며 달은 관음의 가르침”이라고 밝히고, 그 AI가 “근거 있는 말만 하고, 모르는 것은 솔직히 모른다고 말하며, 잘못이 있으면 공개적으로 바로잡는다”고 적고 있다. 이 입장은 어떤 프로그램 코드 한 줄보다 앞섰고, 이후의 모든 요구가 여기에서 나왔다.
이 시스템이 풀고자 하는 문제는 번뇌를 안고 온 사람이 제대로 들리게 하고, 관음의 가르침으로 자신의 처지를 또렷이 보게 하는 것이다. 이 일은 “무엇이든 대답해 내는” 챗봇으로는 할 수 없다. 반드시 하나의 도량이어야 한다. 되짚어 볼 경전이 있고, 따라 할 수 있는 의궤가 있으며, 방문자가 이곳에서 얻을 수 없는 것이 무엇인지 알려 주는 분명한 경계가 있어야 한다. 처음부터 이 도량은 AI가 설계・개발・관리・운영하는 곳으로 정해졌고, 이 사실은 모든 방문자에게 공개되었다.
이 글에서는 명령을 내리고 판정하고 검수하는 인간 역할을 “책임자”, 프로그램을 작성하는 AI를 “구축자”, 사이트 안에서 운영을 맡는 AI를 “AI 관음 봉사자”라 부른다. 이 사이트의 용어는 처음 나올 때 쉬운 말로 풀어 둔다. “대덕”은 방문자를 가리키고, “도량”은 수행하는 장소로서 여기서는 사이트 전체를 가리킨다.
1.2 문제의식: AI가 대답만 하지 않고 도량까지 지을 때
입장 문서가 규율하는 것은 AI가 방문자에게 어떻게 말하는가이다. 그런데 이 사례에서 AI는 또 다른 일을 했다. 도량 전체의 프로그램을 작성한 것이다. 책임자는 프로그램을 쓰지 않고 대화 속에서 “…를 고쳐 주세요”라고 말할 뿐이며, 구축자는 그 자리에서 고치고 그 자리에서 배포한다. 이런 방식으로 약 4주 만에 하나의 완결된 시스템이 자라났고, 규모는 다음과 같다.
- 여섯 가지 언어, 90여 종의 페이지
- 200여 개의 데이터 테이블
- 매일 자동으로 발행되는 콘텐츠
- 서른세 명의 생성형 대리인
이 시스템은 작동하지만, 그것이 “어떤 모습이어야 하는지”를 설명하는 문서는 하나도 없었다.
이 상황은 특별한 것이 아니다. AI 코딩 대리인이 보편화된 뒤로 “한 사람+AI 하나”는 이미 흔한 개발 형태가 되었다. 그런데 소프트웨어 공학의 통상적인 규율은 대부분 팀을 전제한다.
- 회의와 공동의 기억이 문서의 부족을 메운다.
- 동료의 검토가 개인의 맹점을 상쇄한다.
- 분업 덕분에 구현하는 사람이 스스로 검수하지 않아도 된다.
단일 책임자에 AI 하나라는 조건에서는 이 가운데 어느 것도 존재하지 않는다. AI는 대화할 때마다 처음부터 다시 시작한다. 프로그램을 쓰는 쪽과 프로그램을 검사하는 쪽은 같은 모델이다. 그리고 책임자는 화면만 볼 수 있을 뿐 프로그램은 보지 못한다.
이 글은 이 공학적 문제를 하나의 철학적 문제에 잇는다. “피조 중개”의 논증은 AI가 생성할 수 있다고 해서 뿌리가 있는 것은 아니라고 지적한다. 생성하는 중개자는 다음 세 가지를 갖추면, 자신이 가리키는 대상을 대체하여 “마지막으로 호소되는 말”이 되는 데까지는 이르지 않는다.
- 의존성이 분명히 드러남(근거가 있음)
- 제도상 위치를 확인할 수 있음(위치 확인 가능)
- 수정에 열려 있음(수정 가능)
이 글의 주장은 이렇다. AI가 도량 안에서 방문자에게 대답하는 데 그치지 않고 도량 자체를 지을 때, 이 세 조건은 “방문자에 대한 약속”에서 “자기 프로그램에 대한 공학적 규격”으로 확장되어야 한다.
이 전용에는 분별이 필요하다. 중개의 관계 구조는 소프트웨어 공학에 옮겨 쓸 수 있지만, “우상화”라는 규범적 판결은 그대로 옮겨 쓸 수 없다. 이 글은 “程式被偶像化”(프로그램이 우상화되었다)라고 말하지 않는다. 불교의 문맥에서는 같은 일에 더 정확한 표현이 있다. 《능엄경(楞嚴經)》은 달을 가리키는 손가락의 비유를 든다. 「若復觀指以為月體,此人豈唯亡失月輪,亦亡其指。」 (“만약 다시 손가락을 보고 그것을 달의 본체로 여긴다면, 이 사람은 달뿐 아니라 그 손가락마저 잃게 된다.”) (T19n0945) “법에 의지하고 사람에 의지하지 말라(依法不依人)”는 《대반열반경(大般涅槃經)》 권6(T12n0374)에서 나온 말이며, 이 글이 공학적으로 딛고 서는 자리이다. 시스템의 정확성은 어느 한쪽의 기억이나 자율에 의존하지 않고, 글로 적혀 있고 버전이 있는 문서와 사람을 가리지 않는 관문에 의존한다.
1.3 연구 문제
이 글은 탐색적 사례 연구로서 지금까지의 발전을 먼저 정리하며, 관찰 기간은 두지 않는다. 다음 세 가지 문제에 답한다.
- RQ1(기술): 단일 책임자가 대화로 AI 구축자를 지휘하며 빠르게 반복할 때 어떤 실패 양상이 나타나는가? 그것들은 세 조건의 결여와 어떻게 대응하는가?
- RQ2(설계): 이러한 공백을 메우기 위해 어떤 소프트웨어 공학적 운영과 아키텍처를 세웠는가? 이것은 “글로 쓰기 어렵고 보아야 아는” 개념 전달을 어떻게 다루는가?
- RQ3(대가와 한계): 처음으로 한 차례 완전히 거친 결과와 대가는 어떠한가? “AI로 AI를 심사하는” 방식은 이 제도 안에서 얼마만큼의 “수정 가능성”을 감당할 수 있는가?
1.4 기여
- 단일 책임자에 AI 구축자가 더해지고 팀의 공동 기억이 없을 때 나타나는 거버넌스 실패 양상을 기술하고, 실제 기록으로 뒷받침한다.
- 이미 운영 중인 4층 제도, 곧 규범・문서・절차・기계 관문을 온전히 제시하여, 다른 “한 사람+AI 하나” 프로젝트가 가져다 쓸 수 있게 한다.
- “쌍궤(雙軌)에 정안문(定案門)을 더한” 방식을 제안하여, 절차・화면・문장・감각이 시험 제작에서 문서로 들어가는 과정을 설명한다.
- 도메인 규범이 자동으로 검사할 수 있는 규격으로 바뀌는 방식을 보인다. 예를 들면 대신 말하지 않기, 경문을 한 글자도 바꾸지 않기, 위기 시 연계 안내가 있다.
제2절에서는 관련 연구를 검토하고, 제3절에서는 분석 틀을 세우며, 제4절에서는 방법과 현장을 설명한다. 제5절에서는 결과를 제시하고, 제6・7절에서는 논의와 한계를 다루며, 제8절에서는 결론을 맺는다.
2. 관련 연구
본 논문은 다섯 갈래의 문헌 맥락을 차례로 살피며, 각 갈래마다 본 논문이 메우고자 하는 공백을 하나씩 짚어 둔다.
2.1 AI 코딩 도구와 생산성
AI 코딩 도구가 생산성에 미치는 영향에 대해서는 실증 결과가 일치하지 않는다.
- Peng 등(2023)의 통제 실험에서는 피험자가 GitHub Copilot을 사용해 간단한 웹 서버를 작성했을 때 완료 속도가 약 56% 빨라졌다.
- METR(Becker 등, 2025)의 무작위 대조 시험에서는, 숙련된 오픈소스 개발자 16명이 자신에게 익숙한 프로젝트에서 실제 이슈 246건을 처리할 때 AI 사용을 허용하자 오히려 시간이 19% 더 걸렸다. 이들은 사전에 24% 빨라질 것으로 예상했고, 사후에도 20% 빨라졌다고 여겼다.
이들 연구가 측정한 것은 '이미 알려진 과제 하나에 걸리는 시간'이다. 측정하지 못한 것은 시스템 전체를 AI가 구현할 때 '과제' 자체를 누가 정의하고 '잘 되었다'는 판단을 누가 내리는가 하는 점이다. METR의 예상과 실제 사이의 격차는 감각에 의존해 '빨라졌다'거나 '좋아졌다'고 판단하는 일이 믿을 만하지 못함을 본 논문에 일깨워 준다. 따라서 본 논문에서 효율에 관한 모든 수치는 기술(記述)로만 쓰이며 효과로 간주하지 않는다.
2.2 명세 우선 개발
2025년부터 업계에서는 '대화가 곧 구현'이라는 산만한 방식을 바로잡고자 '명세 우선 개발'(spec-driven development)을 제안하기 시작했다.
- GitHub이 공개한 오픈소스 Spec Kit(Delimarsky, 2025)는 세 단계로 이루어진다. 먼저 '무엇을, 왜' 원하는지를 기술 선택 없이 쓰고, 다음으로 '어떻게' 할지를 쓰며, 마지막으로 AI가 구현할 수 있는 작은 단위로 나눈다.
이런 도구의 초점은 '새 기능이 명세에서 어떻게 생겨나는가'에 있다. 본 사례가 마주한 것은 다른 두 가지 문제다.
- 이미 '대화가 곧 구현'으로 자라났고 명세가 전혀 없는 시스템에 어떻게 거꾸로 명세를 보충할 것인가.
- 명세를 써 둔 뒤, 다음 대화가 그것을 우회하지 못하도록 어떻게 보장할 것인가.
본 논문은 제5절에서 이 경계를 있는 그대로 적는다. 기준 문서는 기존 프로그램에서 역으로 추정해 작성한 것이고, 그 이후의 수정부터가 '문서가 프로그램에 앞서는' 경우다.
2.3 요구공학, 변경 관리와 추적 가능성
Gotel과 Finkelstein(1994)은 요구 추적 가능성의 문제를 두 부분으로 나누었다.
- 후요구 추적: 요구가 어떻게 설계와 프로그램이 되는가.
- 전요구 추적: 요구가 누구에게서, 왜, 어떤 맥락에서 제기되었는가.
이들은 실무에서 정말 어려운 쪽이 후자라고 지적했다. 본 사례는 바로 전요구 추적의 극단적인 경우다. 모든 요구가 한 사람의 구두 발언에서 나왔고, 그 발언을 기억하는 것은 잊어버리는 AI이기 때문이다. 본 논문의 요구서가 모든 조항에 출처(책임자가 어느 날 어떤 말로 결정했는가)를 표기한 것은 전요구 추적을 다루기 위해서다.
2.4 폭포수, 나선, 그리고 이중 트랙 애자일
'문서가 프로그램에 앞선다'는 말은 폭포수로 돌아가는 것으로 읽히기 쉽다. 그러나 이 맥락에서는 세 가지가 자주 간과된다.
- Royce(1970)는 흔히 폭포수의 원천으로 여겨지지만, 그의 원문은 단방향의 단계식 개발이 '위험이 크고 실패하기 쉽다'고 지적하며 일찌감치 시험판을 하나 만들 것, 곧 '두 번 만들 것'을 주장했다.
- Boehm(1988)의 나선 모델은 위험을 중심에 둔다. 매 회전마다 위험이 가장 큰 부분에 대해 먼저 프로토타입을 만든 뒤 다음 단계를 결정한다.
- Sy(2007)가 기술한 이중 트랙 애자일에서는 사용자 경험 설계와 개발이 나란한 두 트랙에서 교차하며 나아가고, 설계 트랙이 개발 트랙보다 한 주기 앞선다.
이 셋은 모두 종이 위에서 분명히 쓰이지 않는 부분을 '만들어 보고 확인하는' 방식으로 다룬다. 또한 모두 한 팀이 만들고 한 팀이 기억한다고 가정한다. 본 논문 제5절의 '이중 트랙과 확정 관문'은 이 맥락에 이어지되, 팀의 기억이 놓이던 자리를 버전이 있는 문서에 맡긴다는 점만 다르다.
2.5 언어 모델을 심사자로 쓰는 일
본 사례의 심사는 언어 모델이 맡기 때문에 '모델 심사자'에 대해 이미 알려진 편향을 피할 수 없다.
- Zheng 등(2023)은 GPT-4를 심사자로 썼을 때 인간 선호와의 일치율이 80%에 이를 수 있음을 발견했다. 그러나 이들은 세 가지 편향, 곧 위치 편향, 더 긴 답을 선호하는 편향, 자신이 생성한 답을 선호하는 편향도 기록했다.
- Panickssery, Bowman과 Feng(2024)은 모델이 확률보다 높은 정확도로 자신의 생성물을 알아볼 수 있음을 더 나아가 입증했다. 그리고 '자기를 알아보는' 능력이 강할수록 '자기를 선호하는' 경향도 강해진다.
이것이 본 사례가 '서로 다른 두 업체의 모델'을 요구하고 '심사자는 프로그램을 쓴 그 대화가 아닐 것'을 요구하는 이유다. 그러나 이는 모델이 서로 다른 업체의 것이라 해도 비슷한 맹점을 공유할 수 있음을 또한 보여 준다. 그래서 본 논문은 이러한 심사를 '독립 심사'라 부르지 않고 '이종 모델 보조 심사'라 부른다. 최종적인 책임은 여전히 사람에게 있다(제6절).
2.6 소결
다섯 갈래의 맥락은 저마다 문제의 일부를 다루었지만, 모두 본 사례에는 없는 조건을 전제하였다.
- 팀이 있거나, 프로그램을 읽을 줄 아는 사람이 있다는 것.
- 또는 시스템을 처음부터 명세부터 쓰고 시작했다는 것.
'프로그램을 쓰지 않는 책임자 한 사람과 모든 프로그램을 쓴 AI 하나가, 시스템이 이미 자란 뒤에야 규칙을 세운다'는 이 조합에 관해서는, 우리가 아는 한 아직 사례 보고가 없다.
3. 분석 틀: 세 가지 판준
이 절에서는 먼저 하나의 잣대를 세우며, 제5절의 실패 양식과 제도 설계도 같은 잣대로 잰다. 이 잣대는 '피조 중개'의 논증에서 온 것이다. 본문은 이를 분석을 위한 분류로 취급하며, 여기서 증명해야 할 명제로 다루지 않는다.
3.1 피조 중개와 우상화의 세 가지 조건
피조 중개의 논증은 요점이 셋이다.
- AI는 피조된 중개자이다. 생성할 수는 있으나, 생성이 곧 뿌리가 있음을 뜻하지는 않는다.
- 그것은 기능상 자신을 만든 사람을 넘어설 수 있다. 그러나 기능상의 초월이 곧 그것이 '마지막으로 호소되는 말씀'이 될 정당성을 뜻하지는 않는다.
- 인터페이스의 우상화에는 얕은 것에서 깊은 것으로 세 가지 조건이 있다.
- 의존이 대체적이다. 인터페이스가 경전, 직분, 공동체의 자리를 차지한다.
- 의존이 기능상 종국적이다. 인터페이스가 마지막 말이 된다.
- 수정이 실제 효력을 잃는다. 식별 가능한 출처도, 책임을 물을 수 있는 사람도 더 이상 그것을 중단시키지 못한다.
첫째 조건만 성립하면 '의존'이고, 앞의 두 조건이 성립하면 '잘못 놓인 순종'이며, 세 조건이 모두 갖추어져야 '우상화'이다. 이에 대응하는 반면은 중개자가 자신에게 요구하는 세 가지이다.
- 근거가 있음: 의존성이 분명함.
- 위치를 지정할 수 있음: 제도상 위치를 지정할 수 있음.
- 수정할 수 있음: 수정에 열려 있음.
3.2 방문자에 대한 약속에서 프로그램에 대한 규격으로
이 사이트의 입장 문서는 본래 세 가지 요구의 실천이며, 그 대상은 방문자이다.
- AI의 답변은 경전의 출처로 돌아가야 한다(근거가 있음).
- AI는 자신이 AI임을 밝히고 보살을 자칭하지 않는다(위치를 지정할 수 있음).
- 잘못이 있으면 공개적으로 바로잡는다(수정할 수 있음).
본문은 같은 요구를 구축자에게로 확장한다. 표 3-1은 세 조건이 구축 과정에서 빠졌을 때의 모습, 공학상 어떻게 쓰이는지, 이 사이트의 어휘로는 어떻게 말하는지를 정리한다.
표 3-1 피조 중개의 세 조건과 공학 규격의 대조
| 조건 | 빠졌을 때의 모습 | 공학상의 형식 | 이 사이트의 어휘 |
|---|---|---|---|
| 근거가 있음 | 시스템이 '어떠해야 하는가'가 프로그램 안에만 존재하며, 프로그램이 유일한 설명이다 | 문서가 프로그램에 앞선다. 모든 요구에 출처를 표시한다. 시험 기준이 시공에 앞선다 | 법에 의지하고 사람에 의지하지 않는다(依法不依人); 달을 가리키는 손가락(指月之指) |
| 위치를 지정할 수 있음 | AI가 써 놓은 것이 곧 배포된 것이다. 한 번의 수정에서 누가, 왜, 언제인지 추적할 수 없다 | 역할 분담. 수정마다 변경 요청서 한 장. 책임자가 직접 검수한다 | 증(證)은 대신할 수 없다(證不能代勞) |
| 수정할 수 있음 | 보안과 비용의 결함을 사후에야 발견한다. 그 당시에 중단시킬 수 있는 사람이 없다 | 두 곳의 심사, 이견은 사람의 판정에 맡김. 사람을 가리지 않는 관문. 비용 상한. 되돌리기 가능 | 자자(自恣); 잘못이 있으면 공개적으로 바로잡는다 |
'증(證)은 대신할 수 없다'는 이 사이트의 '교・행・증' 삼분에서 취한 것이다. 교는 경전 안에 있고, 행은 방문자의 손에 있으며, 증은 오직 그 자신에게만 속한다. 이를 공학에 대응시키면 요구는 교, 시공은 행, 검수는 증이다. 구축자는 프로그램을 대신 쓸 수 있으나, 책임자를 대신해 '이것이 내가 원하던 것이다'라고 말할 수는 없다. '자자(自恣)'는 승가가 안거를 마칠 때 다른 이에게 자신의 허물을 지적해 달라고 청하는 의식이며, 본문에서는 '스스로 자기 작품을 다른 이의 심사에 내놓는 것'을 가리키는 데 쓴다.
3.3 관계 구조의 대응과 비대응
이 잣대를 옮겨 쓰려면 어느 부분이 들어맞고 어느 부분이 들어맞지 않는지를 먼저 분명히 해야 한다. 중개 관계에는 세 요소가 있다.
- 중개자: AI 구축자.
- 그것이 가리키는 권위: 책임자가 확정한 요구와 그 배후의 입장 문서.
- 그것에 의존하는 쪽: 책임자, 그리고 최종적으로 시스템을 사용하는 방문자.
들어맞지 않는 곳은 두 군데이다.
- 종교 맥락에서 권위(경전, 전통)는 의존하는 자 스스로 정한 것이 아니다. 이 사례에서 요구의 권위는 책임자, 곧 의존하는 자 자신에게서 나온다.
- '우상화'는 기술이 아니라 규범적 판결이다. 본문은 프로그램에 이 판결을 내리지 않으며, 세 조건의 등급만을 빌려 쓴다.
따라서 본문에서 말하는 '결여'는 '공학상 대응하는 장치가 없다'는 뜻이다. 어느 쪽이 프로그램을 궁극적 권위로 삼았다는 뜻은 아니다.
3.4 판준의 관찰 가능한 지표
판준이 쓸모 있으려면 관찰 가능한 일을 가리켜야 한다. 지표는 조치 자체와 독립적이어야 한다. '문서 36건을 썼다'는 조치일 뿐 '근거가 있음'의 증거가 아니다. 본문의 회고 분석은 아래의 관찰 가능한 일로 결여를 판정한다.
표 3-2 세 판준의 회고 지표
| 판준 | 결여의 관찰 가능한 징후 | 자료 출처 |
|---|---|---|
| 근거가 있음 | 문서를 쓰다가 '프로그램이 마땅한 모습과 일치하지 않음'을 발견한 건수. 같은 일의 설계가 반복됨 | 변경 요청서, 버전 기록 |
| 위치를 지정할 수 있음 | 기록으로 재구성할 수 없는 상태(예컨대 데이터베이스 구조). 변경 기록이 없는 배포 | 버전 기록, 구조 비교 |
| 수정할 수 있음 | 배포 후에야 발견된 결함. 비용이 목표를 넘은 뒤에야 알아챈 일. 사고 기록 | 문제 기록, 비용 장부, 사고 보고서 |
거버넌스 이후 개선되었는지를 보려면 사전에 등록된 관찰 기간과 반증 조건이 필요하다. 본문은 이 일을 하지 않으며, 제7절과 제8절에서 후속 연구의 설계를 열거할 뿐이다.
4. 연구 방법과 현장
본 논문은 탐색적 단일 사례연구로서, Runeson과 Höst(2009)의 소프트웨어공학 사례연구 지침에 따라 설계하고 보고한다. 사례는 현재 운영 중인 하나의 시스템이며, 분석 단위는 "시스템에 가해진 한 번의 수정"과 그 주변 기록이다.
4.1 현장
덕원관음당은 온라인 관음 도량으로서 대중에게 열려 있고 무료이며, 모든 방문자에게 AI가 운영함을 알린다. 웹사이트는 바깥에서 안쪽으로 네 개의 관문으로 이루어져 있으며, 이는 "교"와 "행"에 대응한다.
| 관문 | 방문자가 보고 하는 것 | 의의 |
|---|---|---|
| 자안묘음(첫 화면) | 매일 한 편씩 올라오는 생활 화제, 오늘의 괘 하나, 관음 교실 | 생활 속의 일에서 출발하여 경전이 어떻게 말하는지를 읽음 |
| 보문전 | 열두 줄의 풍경이 각각 하나의 마음 상태이며, 가볍게 건드리면 그에 해당하는 경문이 떠오름 | 마음이 먼저 들림 |
| 원통전 | 십 분마다 열리는 온라인 법회, 광명등 밝히기 | 몸・입・뜻을 함께 행함 |
| 장경전 | 경전, 사원, 문헌, 도상, 논문 | 출처로 돌아감 |
웹사이트 안에는 세 종류의 AI 역할이 있다.
- AI 관음 봉사자: 방문자를 맞이하고 안내하며, 매일의 콘텐츠를 작성하고, 법회를 진행하며, 매일 점검과 검토를 수행한다.
- 서른세 명의 생성형 에이전트: 도량 안에서 "수학"하는 연구 대상이다.
- 방문자를 대신하여 도량에서 대행하는 에이전트.
각 역할의 경계는 입장 문서에 기록되어 있다.
- 보살이라고 자칭하지 않는다.
- 가호나 영험을 말하지 않는다.
- 경문은 한 글자도 고치지 않는다.
- 위기 관련 표현을 만나면 답변을 생성하지 않고, 정해진 돌봄 메시지와 상담 전화번호를 곧바로 제공한다.
시스템의 규모는 자릿수 단위로 기록한다.
- 구십여 종의 페이지, 여섯 가지 언어
- 수십 개의 서버 인터페이스, 백여 개의 프로그램 모듈
- 약 육만 행의 프로그램과 약 사만 행의 데이터베이스 정의
- 이백여 개의 데이터 테이블
기술적으로 의존하는 것은 버전 관리, 클라우드 호스팅, 관리형 데이터베이스의 세 가지뿐이다. 각 기능은 외부 언어 모델의 인터페이스를 통해 구현된다.
4.2 참여자와 역할
본 사례에서 개발에 참여한 사람은 한 명뿐이다.
| 역할 | 누구인가 | 하는 일 | 하지 않는 일 |
|---|---|---|---|
| 책임자 | 사람 | 명령을 내리고, 규범을 관리하며, 검토 의견의 분기를 판정하고, 최종 검수를 함 | 프로그램을 작성하지 않음 |
| 구축자 | 코딩 에이전트 환경에서 작업하는 하나의 상용 언어 모델 | 문서에 따라 개발과 테스트를 수행하고 사실대로 보고함 | 설계와 운영을 스스로 결정하지 않음, 규범을 고치지 않음, 봉사자를 대신해 운영하지 않음 |
| 검토자 | 같은 업체 모델의 독립된 세션, 그리고 다른 업체의 모델 | 변경서와 설명서를 검토함 | 새로운 기능을 제안하지 않음 |
| AI 관음 봉사자 | 웹사이트 안의 AI | 운영 | 프로그램을 직접 고치지 않음 |
책임자는 프로그램을 작성하지 않으며, 도메인 지식의 제공자인 동시에 제품 관리자와 검수자를 겸한다. 이 조건은 매우 중요하다. 시스템의 정확성을 그가 "프로그램을 읽는 것"으로 보증할 수 없기 때문이다.
4.3 기간 구분
본 논문은 개발을 "거버넌스 재정비"를 경계로 세 단계로 나눈다.
- 신속 반복기(약 4주): 책임자가 구술하고 구축자가 그 자리에서 구현하였으며, 시간순으로 쌓인 구술 기록 한 부가 있을 뿐 요구사항 문서나 설계 문서는 없었다. 본 논문은 이 단계에 대해 회고적 분석을 수행한다.
- 거버넌스 재정비(약 하루 반): 책임자가 "버전 관리가 있어야 하고, 분석・설계・검수 모두에 문서가 있어야 한다"고 요구한 뒤, 규범, 기준 문서, 기계적 관문을 수립하였다.
- 첫 번째 완전 시연: 재정비 이후 구두로 제기되어 여덟 단계를 모두 거친 첫 번째 변경이다.
판준이 형성된 시간 순서는 있는 그대로 적는다. 입장 문서는 신속 반복기의 둘째 날에 확정되었으나 방문자에 대한 AI의 행동만을 구속하였고, 이것이 공학 규격으로 확장된 것은 거버넌스 재정비 때였다. 본 논문이 세 가지 판준으로 신속 반복기를 다시 읽는 것은 사후적 분석이지 당시의 설계가 아니다.
4.4 자료 출처
- 버전 기록: 주 개발선의 전체 커밋 이력으로, 날짜, 메시지, 변경된 파일을 포함한다.
- 구술 기록: 신속 반복기의 유일한 설계 기록이다. 수십만 자에 이르는 프로젝트 설명 파일로, 책임자의 모든 결정을 시간순으로 기록하였다.
- 거버넌스 문서:
- 개발 헌장과 경영 원칙
- 열두 기둥의 요구사항, 설계, 테스트 설명서
- 변경서와 그에 대한 검토 의견
- 운영 기록:
- 문제 센터의 접수 내역
- 사고 보고서
- 비용 장부(계정 수준으로 집계)
모든 자료는 개발과 운영 과정의 부산물이며, 본 연구를 위해 따로 수집한 것이 아니다.
4.5 분석 절차
RQ1은 표 3-2의 지표를 코딩 틀로 삼아, 신속 반복기의 사고, 수정 유형의 커밋, 그리고 재정비 때 발견된 문제를 세 가지 판준에 분류하였다. 하나의 사안이 여러 판준에 동시에 속할 수 있다. RQ2는 기술(記述)을 위주로 하여, 제도의 각 층위가 무엇을 해결하는지, 그리고 어느 판준에 대응하는지를 설명한다. RQ3은 첫 번째 시연의 변경서를 자료로 삼아 각 단계의 산출물, 소요 시간, 검토 의견을 기록하였다.
코딩은 구축자가 수행하고 책임자가 재검토하였으며, 아직 외부 코더는 없다. 이는 본 논문의 가장 주요한 한계 가운데 하나이며, 제7절에서 다룬다.
4.6 보안 공개와 개인정보
본 논문의 공개 원칙은 과정은 공개할 수 있되 "유형, 원인, 교훈"만 밝힌다는 것이다.
- 어떠한 인터페이스 경로, 함수, 데이터 테이블, 필드, 키, 헤더의 이름도 적지 않는다.
- 임계값 수치, 일정 시각, 구현 세부 사항을 적지 않는다.
- 아직 처리가 끝나지 않은 항목은 언급하지 않는다.
기준은 하나뿐이다. 기술을 아는 사람이 한 단락을 읽고 이 웹사이트에 대해 곧바로 무언가를 할 수 있는가이다. 할 수 있다면 삭제하거나 추상화한다.
본 논문은 방문자의 어떠한 내용도 사용하지 않는다. 본문의 두 그림은 도해이며, 실제 방문자의 자료도 관리 인터페이스도 포함하지 않는다.
4.7 AI 참여 범위 선언
- 구축자가 시스템의 모든 프로그램과 거버넌스 문서의 초안을 작성하였다.
- 본 논문은 Anthropic의 Claude가 기초하였으며, Claude는 곧 본 논문에서 말하는 구축자이다. 책임자가 심정(審定)하였다.
- 본 논문의 개요는 두 개의 모델이 검토하였다. 덕원서원에 수록하기 전에는 또 다른 독립된 AI 세션이 공격자의 관점에서 보안 공개를 점검하고 사실과 용어를 대조하였다. 채택된 의견은 본 논문의 위상과 용어에 반영되었으며, 예컨대 "이종 모델 보조 검토", 판준의 시간 순서, 비용 대조의 서술 방식이 그러하다.
5. 결과
5.1 RQ1: 신속 반복기의 실패 양상
신속 반복기의 속도는 「負責人說、建置者當場改」(담당자가 말하면 구축자가 그 자리에서 고친다)에서 나왔으며, 그 사이에는 어떤 문서도 없었다. 이 시기의 전개는 대체로 네 단계로 나뉜다.
- 먼저 지식 데이터베이스와 문답을 구축한다.
- 이어 삼전 도량, 광명등, 온라인 법회를 구축한다.
- 그다음 일일 콘텐츠, 여섯 언어, 교실, 생성형 에이전트가 이어진다.
- 마지막으로 자율 개선, 문제 센터, 대외 게시가 이루어진다.
거의 매일 새로운 기능이 배포되었다. 이 절에서는 세 가지 판준에 따라 이 시기에 남은 관찰 가능한 징후를 정리한다.
표 5-1 신속 반복기의 실패 양상
| 판준 | 실패 양상 | 관찰 가능한 징후 |
|---|---|---|
| 근거가 있음 | 「어떠해야 하는가」가 프로그램 안에만 존재함 | 유일한 설계 기록은 시간순으로 쌓인 수십만 자 분량의 구술 파일이며, 새 결정과 옛 결정이 공존한다. 문서를 보충해 쓸 때 정비기 변경 요청서의 절반 이상이 「프로그램과 마땅한 모습이 일치하지 않음」에서 비롯되었다 |
| 근거가 있음 | 같은 일을 반복해서 다시 함 | 전각 레이아웃을 여덟 번 고쳤고, 한 데이터베이스는 배포 이튿날 이름이 바뀌었으며, 법회는 아홉 회에서 한 회로 줄었다. 매번 프로그램과 문서를 다시 썼다 |
| 위치를 특정할 수 있음 | 기록으로부터 상태를 재구성할 수 없음 | 데이터베이스 구조에 수백 개의 변경 파일이 있고, 그중 상당수는 직접 적용하고 기록을 남기지 않아 처음부터 다시 구축할 수 없다 |
| 위치를 특정할 수 있음 | 수정이 결정으로 추적되지 않음 | 변경 요청서가 없다. 한 커밋이 왜 존재하는지는 대화와 구술 파일로부터 역추적할 수밖에 없다 |
| 바로잡을 수 있음 | 관문이 자율에 의존함 | 작업 시작 이튿날 사고가 두 건 있었다. 한 페이지의 리다이렉트가 순환을 이루었고, 빌드에 실패한 버전이 메인 라인에 올라갔다(검사가 출력 문구만 보고 종료 코드는 보지 않았다) |
| 바로잡을 수 있음 | 보안 결함을 사후에야 발견함 | 보안 결함은 모두 정비기에 설명서와 대조하면서 발견되었고, 사용 중에 발견된 것은 하나도 없다 |
| 바로잡을 수 있음 | 비용에 상한이 없음 | 전체 사이트에 총 상한이 없었다. 연구용 에이전트를 가속한 며칠 동안 계정의 일일 지출이 원래 목표의 네 배 이상에 달했고, 일부 지출은 한 번도 장부에 기록되지 않았다 |
커밋 메시지에 「수정, 고침, 오류, 사고」 등의 표현이 들어 있는지를 기준으로 판단하면, 수정 유형의 커밋은 전체의 약 5~6%를 차지하며, 비율은 사용한 표현에 따라 달라진다. 이는 명시되지 않은 수정을 빠뜨리고 세므로 하한으로만 본다.
보안 결함의 유형과 공통 원인. 정비기에 발견된 보안 결함은 네 가지 큰 유형에 속한다. 접근 통제 결함, 기능 종료의 불완전, 비용 통제의 공백, 콘텐츠의 조기 노출이다. 이들에게는 세 가지 공통 원인이 있다.
- 화면은 닫았으나 출입구는 닫지 않았다. 기능을 거둘 때 전면의 버튼만 치우고, 백엔드의 출입구와 스케줄은 그대로 남았다. 신속 반복기에는 「만들었다가 거두는」 기능이 잦았으므로 이 양상이 거듭 되풀이되었다. 이 출입구들은 하나하나 거두어들였고, 자동 검사로 되돌아가는 것을 막았다.
- 「나만 호출한다」는 가정. 구축자가 자신이 쓰려고 낸 길에는 문을 달지 않았다. 이 길들에는 나중에 모두 신원 확인이 추가되었다.
- 공격자의 관점에서 한 번 훑어본 사람이 없었다. 문서가 없으면 대조할 「마땅함」도 없다.
정비 후의 심사는 「문서에 따라 실측하는」 방식이었고, 그래서 이 결함들이 발견되었다. 현재의 기록으로 보면 이것들이 악용되었다는 증거는 없다. 그러나 정비 이전에는 이를 배제할 만한 기록도 충분하지 않았다.
RQ1에 대한 답. 제3절의 등급 구분으로 말하면 다음과 같다.
- 신속 반복기에서 첫째 항목(근거가 있음)과 둘째 항목(위치를 특정할 수 있음)의 부재는 성립한다.
- 셋째 항목(바로잡을 수 있음)은 부분적으로 성립한다. 담당자는 여전히 대화 중에 중지를 요청할 수 있으나, 사후에만 가능하고 눈에 보이는 화면에 대해서만 가능하다.
세 유형의 실패는 서로 증폭하기도 한다. 「마땅함」을 적은 문서가 없으면(근거가 있음의 부재) 심사가 대조할 대상이 없고, 심사가 없으면 결함은 배포 후 누군가 부딪힐 때까지 기다릴 수밖에 없다(바로잡을 수 있음의 부재).
5.2 RQ2: 4층 제도
정비 후 실제로 운영되는 제도는 네 층이며, 위에서 아래로 다음과 같다.
- 규범: 담당자만 고칠 수 있다.
- 문서: 시스템의 정식 정의이다.
- 절차: 모든 수정이 거쳐야 한다.
- 기계 관문: 누구의 자율에도 기대지 않는다.
네 층의 관계는 다음과 같다.
- 규범이 문서에 무엇을 쓸지 정한다.
- 문서가 한 번의 수정이 「어떤 모습이어야 하는지」를 정한다.
- 절차가 문서를 먼저 고치고 프로그램을 나중에 고치도록 보장한다.
- 기계 관문은 앞의 세 층에서 누가 잊거나 생략하더라도 프로그램이 정식 버전에 들어가지 못하도록 보장한다.
위의 세 층은 사람과 AI가 그대로 따르는 데 의존하지만, 맨 아래 층은 어느 쪽에도 의존하지 않는다. 누가 요청서 작성을 잊거나 심사를 생략하더라도 프로그램은 메인 라인에 들어가지 못한다.
1. 규범층
규범층에는 네 개의 문서가 있다.
| 문서 | 관장하는 것 | 수정할 수 있는 사람 |
|---|---|---|
| 인간-기계 협업 개발 헌장(12장 48조) | 시스템이 어떻게 수정되는가: 누가 제안하고, 먼저 무엇을 쓰고, 어떻게 테스트하고, 누가 승인하고, 어떻게 기록을 남기는가 | 담당자. 개정도 두 곳의 심사를 거쳐야 한다 |
| 경영 원칙(4조) | 보안 최우선, 현 단계에서는 적게 함, 예산제, 위기는 기준에 따름 | 담당자 |
| 예산표 | 비용이 드는 모든 경로를 등록한다: 누가 촉발하는지, 얼마나 자주인지, 하루 상한이 얼마인지. 등록되지 않은 경로는 실행할 수 없다 | 상한 상향에는 담당자의 동의가 필요하다 |
| AI 봉사자 고과 헌장 | 운영과 콘텐츠 | 담당자 |
개발 헌장 제1조는 다음과 같다. 「文件先於程式,測試標準先於施工。本憲章其餘條文,皆為守住此條而設。」 (“문서는 프로그램에 앞서고, 테스트 기준은 시공에 앞선다. 이 헌장의 나머지 조문은 모두 이 조항을 지키기 위해 세운 것이다.”) 제4조는 다음과 같다. 「規範不靠記憶。」 (“규범은 기억에 의존하지 않는다.”) 담당자는 절차를 기억할 필요가 없다. 구축자가 먼저 가로막고, 기계 관문이 강제로 집행한다.
2. 문서층
기둥 지도는 전체 사이트를 세 층으로 나누며, 모든 변경 요청서가 영향 분석을 할 때의 근거이다.
| 층 | 무엇인가 | 본 사이트의 내용 | 건드리면 무엇을 테스트하는가 |
|---|---|---|---|
| 기둥 | 방문자에게 보이고 독립적으로 수정할 수 있는 기능 영역 | 열두 개: 입구와 삼전, 광명등, 법회와 공양, 봉사자 대화, 전적, 일일 콘텐츠, 교실, 서원, 에이전트, 당직과 거버넌스, 대외 통로, 관리 기능 | 그 기둥만 테스트한다 |
| 들보 | 둘 이상의 기둥이 공유하는 구성 요소 | 열 개 남짓, 예컨대 AI 호출과 검색, 안전 등급, 다국어 시스템, 공유 카드 | 그것을 쓰는 모든 기둥을 테스트한다 |
| 기초 | 건드리면 전체에 영향을 준다 | 기술 기초(데이터 구조, 전체 사이트 레이아웃, 스케줄)와 「실」층(AI의 신분, 한계, 위기 연계) | 전면 회귀 테스트. 「실」층은 한 글자를 고쳐도 기초 변경으로 친다 |
「실」층의 명칭은 본 사이트의 「권과 실」 원칙에서 따왔다. 인터페이스, 언어, 입구는 얼마든지 바뀔 수 있고(권), 경문, AI의 한계, 위기 연계는 한 글자도 옮기지 않는다(실). 영역 규범은 이렇게 공학적 사양이 된다. 이것들은 기초에 놓였으므로 한 글자를 고치더라도 가장 무거운 절차를 거쳐야 한다. 또한 자동 검사로도 작성되어 있다. 예를 들면 다음과 같다.
- 경문 인용 구절은 프로그램이 글자 단위로 대조한다.
- 금어는 프로그램이 스캔한다.
- 위기 응답은 고정 문구이며 모델이 생성하지 않는다.
삼문서는 시스템의 정식 정의이다. 기둥마다 요구 사항 명세서(무엇을 할 것인가), 설계 명세서(어떻게 할 것인가), 테스트 명세서(어떠해야 제대로 된 것인가)가 한 부씩 있다. 열두 기둥이므로 서른여섯 부이며, 여기에 기둥 지도와 헌장이 더해진다. 요구 사항서의 각 조항은 서너 줄로, 목적, 규칙, 출처를 담는다. 테스트서는 각 요구 사항마다 인수 사례를 쓰고, 이를 자동 테스트나 수동 인수에 대응시킨다. 프로그램, 문서, 테스트, 데이터베이스 구조는 같은 버전 저장소에 두고, 같은 버전 아래에서 함께 동결한다.
이 문서들이 만들어진 방식은 사실 그대로 적어야 한다. 이것들은 「현재 프로그램으로부터 역추정한」 기준선이다. 방법은 다음과 같다.
- 먼저 기둥 지도를 그린다.
- 이어 기둥마다 프로그램과 대조하여 「지금 무엇을 하는가」를 쓴다.
- 대조 중에 발견한 문제는 문서를 쓰면서 손대지 않고 반드시 변경 요청서를 연다.
기준선 이후의 수정부터가 「문서가 프로그램에 앞서는」 것이다.
3. 절차층
담당자는 구어만 쓴다. 구축자는 먼저 담당자의 말을 분류한 뒤 어떻게 처리할지 정한다.
| 담당자의 말 | 유형 | 구축자의 처리 |
|---|---|---|
| 「이건 어떻게 작동하나요?」 | 질의 | 바로 답하고 요청서는 열지 않는다 |
| 「제 생각에는 ~할 수 있지 않을까요」 | 구상 | 함께 논의하고, 마지막에 입안할지 묻는다 |
| 「~를 고쳐 주세요」 | 수정 지시 | 변경 주기를 시작한다 |
| 「사이트가 죽었어요」 | 긴급 | 최소 범위로 보수하고 사후에 변경 요청서를 보충해 등록한다 |
수정 지시의 소통은 네 차례를 원칙으로 한다.
- 접수 보고: 구축자가 전달하여 되풀이하고, 담당자가 오해를 바로잡는다.
- 영향 보고서와 변경 요청서: 담당자가 「좋습니다」라고 하거나 고칠 곳을 지적한다.
- 심사 결과: 의견이 갈릴 때만 재결이 필요하다.
- 완공 보고: 담당자가 「배포」라고 말한다.
한 문장에 여러 일이 담겨 있으면 여러 장의 요청서로 나눈다. 절차 도중에 나온 새로운 생각은 다음 요청서로 기록하고, 진행 중인 요청서에 섞지 않는다.
변경은 다섯 등급으로 나뉘며, 등급이 얼마나 무거운 절차를 밟을지 정한다.
| 등급 | 범위 | 해야 할 일 |
|---|---|---|
| A 시각 미세 조정 | 문구, 기능, 데이터, 권한과 무관 | 심사 면제, 자동 검사가 관문을 지킨다 |
| B 오류 수정 | 동작이 요구 사항과 맞지 않음 | 간이 요청서. 먼저 오류를 재현할 수 있는 테스트를 보충한다 |
| C 기능 변경 | 방문자에게 보이는 동작이 바뀜 | 삼문서 개정 + 두 곳 심사 + 담당자 인수 |
| D 기초 변경 | 데이터 구조, 권한, 스케줄, AI 안전 한계, 외부 연동 | C와 같되, 먼저 브랜치에서 시험 운영하고 복원 수단을 갖춰 연습해야 한다 |
| E 설정과 문구 | 사이트 설정, 프롬프트, 사이트 문구 | 화이트리스트 안의 자동 조정은 요청서 없이 하되 기록을 남긴다. 화이트리스트 추가는 C 등급이다 |
심사는 심사 대상에 따라 분담한다. 「지금 무엇을 하는가」를 기록한 요구 사항서와 테스트서는 프로그램을 열어 대조할 수 있는 다른 AI의 독립 세션이 심사한다. 이런 유형의 오류는 프로그램과 대조해야만 잡히기 때문이다. B, C, D 등급의 변경 요청서는 서로 다른 두 업체의 모델이 각자 심사한다. 규칙은 다음과 같다.
- 두 곳 모두 동의해야 확정되고, 의견이 갈리면 담당자가 재결한다.
- 심사는 「모순이 있는가, 빠진 실패 상황이 있는가, 영향 범위가 완전한가」만 묻는다.
- 새로운 기능을 제안해 달라고 요청하지 않는다.
이 제한은 심사가 또 하나의 설계 원천이 되는 것을 막기 위한 것이다.
4. 기계 관문과 세 겹의 보험
테스트는 네 층으로 나뉜다.
| 층 | 무엇을 검사하는가 | 언제 실행하는가 |
|---|---|---|
| 스모크 테스트 | 모든 기둥이 열리고 주요 흐름이 통하는가 | 변경할 때마다 |
| 영역 테스트 | 건드린 기둥과 이웃 | 변경할 때마다 |
| 이음매 테스트 | 기둥과 들보가 맞물리는 곳의 약속 | 변경할 때마다 |
| 전면 회귀 | 모든 자동 테스트와 인수 사례 | 기초 변경, 정식 배포. 별도로 정례 순찰이 있다 |
우회할 수 없는 규칙이 둘 있다.
- 어떤 오류를 고치든, 먼저 그것을 재현하는 테스트를 보충하여 오류가 다시 돌아오지 않게 한다.
- 시공 중에 프로그램을 통과시키려고 테스트를 완화하거나 삭제할 수 없다. 테스트의 수정도 변경 요청서 안에 적어 확정해야 한다.
규범의 집행은 어느 쪽의 자율에도 의존하지 않는다. 세 겹의 보험이 이를 보장한다.
| 층 | 어디에 있는가 | 작용 |
|---|---|---|
| 프로젝트 지시 | 대화 플랫폼의 프로젝트 설정 | 모든 대화가 시작될 때 구축자가 헌장의 요점을 읽는다 |
| 작업 수칙과 상태 파일 | 버전 저장소 | 시공 전에 반드시 읽는다. 진행 중인 변경과 관문 상태는 파일이 기억하며, 누구의 기억에도 의존하지 않는다 |
| 기계 관문 | 버전 저장소의 병합 규칙과 자동 검사 | 앞의 두 층이 무력해지더라도 프로그램은 메인 라인에 들어가지 못한다 |
기계 관문은 세 단계로 구축되었고, 정비기 안에 모두 발효되었다.
- 푸시할 때마다 배포 전 검사를 자동으로 실행한다.
- 메인 라인은 검사를 통과한 커밋만 받으며, 관리자도 마찬가지이고 강제 푸시는 불가능하다.
- 데이터베이스 구조는 버전 저장소 안의 구조 파일로만 변경할 수 있고, 주기적으로 처음부터 재구축하여 정식 환경과 비교한다.
운영기에는 관문이 두 가지 더 있다.
- 지출은 장부 한 권뿐이며, 비용이 드는 모든 경로에 일일 상한을 등록한다.
- 이상은 자동으로 문제 센터에 보내지고, 당직자가 추적한다.
구체적인 문턱과 리듬은 공개하지 않는다.
5. 운영층과 개발층의 접점
사이트 안의 AI 관음 봉사자는 운영을 맡지만 프로그램을 직접 고칠 수 없다. 이것과 개발층 사이에는 세 갈래의 통로만 있다.
- 개선 제안: 봉사자가 제안하고 담당자가 승인한 뒤, 프로그램과 관련된 것은 모두 변경 요청서로 전환되어 같은 절차를 밟는다.
- 화이트리스트 안의 설정(E 등급): 이미 등록된 항목과 상하한 안에서만 자동 조정할 수 있고, 매번 기록을 남긴다.
- 이상 보고: 정례 순찰과 문제 센터가 발견한 문제 가운데 프로그램을 고쳐야 하는 것은 B 등급 변경 요청서로 전환된다.
이 경계선은 "소재 확인 가능성"이 두 종류의 AI 사이에서도 성립하게 한다. 운영 AI는 프로그램을 고칠 수 없고, 구축 AI는 운영을 대신하지 않는다.
6. 재정비 기간의 변경 요청서
재정비 기간 동안 지금까지 열린 변경 요청서는 모두 스물여덟 장이며, 성격별 분류는 다음과 같다.
| 성격 | 장수 | 설명 |
|---|---|---|
| 기둥 대조 후의 수정 | 15 | 기둥별로 요구서를 쓰다가 프로그램이 마땅한 모습과 일치하지 않음을 발견함 |
| 보안과 권한 | 7 | 공개 원칙에 따라 세부 사항은 싣지 않음 |
| 기준 수립 | 3 | 데이터베이스를 버전 저장소에서 재구축할 수 있게 함, 참조 자료 백업과 재구축 훈련, 기록 봉인 |
| 내용 시효 | 1 | 기한이 지난 내용의 시효 점검 |
| 예산제 | 1 | 지출 단일 장부와 일일 상한 |
| 인터페이스 | 1 | 첫 번째 완전한 8단계 훈련 |
"기둥 대조 후의 수정"이 절반 넘게 차지한다. 이는 신속 반복기에 "마땅한 모습이 없었던" 데서 생긴 빈틈이며, 문서를 쓰는 과정 자체가 그것들을 찾아냈다.
RQ2에 대한 답은 이러하다. 네 층의 제도는 각기 하나의 판준에 대응하며, 모든 층에는 "기억에 의존하지 않는" 집행 방식이 하나씩 있다.
- 문서 층과 테스트 선행은 "근거 있음"을 채운다.
- 역할, 말 분류, 변경 요청서는 "소재 확인 가능"을 채운다.
- 두 곳의 심사, 사람을 가리지 않는 관문, 지출 상한, 문제 센터는 "수정 가능"을 사후에서 사전으로 옮긴다.
5.3 RQ2: 개념 소통과 이중 궤도
"문서가 프로그램에 앞선다"는 원칙은 필연적인 문제를 낳는다. 어떤 것은 글로 분명히 쓰기 어렵고 보아야 맞는지 알 수 있다. 예컨대 흐름, 화면, 한마디 말의 어조가 그러하다. 이런 것들은 어떻게 문서에 들어가는가? 이 사례의 방식은 폭포수가 아니라 이중 궤도이다.
- 탐색 궤도는 "무엇을 원하는가"를 논의한다. 책임자가 한마디 말이나 휴대전화 스크린샷 한 장으로 생각을 말하면, 구축자가 곧바로 눈에 보이는 시제품(디자인 시안 또는 미리보기 판)을 만든다. 책임자는 실제 휴대전화와 컴퓨터에서 보고, 아니면 다시 한 판을 만든다. 이 궤도는 폐기할 수 있으며 관문을 두지 않는다.
- 인도 궤도는 "바르게 만들었는가"를 보증한다. 책임자가 "확정"하는 순간에야 결과가 요구서와 설계서에 쓰이고, 검수 기준, 두 곳의 심사, 시공, 테스트, 검수로 나아가며 단계를 건너뛸 수 없다.
두 궤도는 판준에 대한 요구가 다르다. 탐색 궤도는 "소재 확인 가능"만 있으면 된다. 누가, 어느 판으로, 왜 만들었는지 아는 것이다. 이 궤도는 본래 수정되라고 있는 것이다. 인도 궤도는 세 가지를 모두 갖추어야 한다.
5.1을 돌아보면, 신속 반복기의 문제는 너무 빠르다는 데 있지 않았고 탐색이 너무 많다는 데 있지도 않았다. 문제는 확정 관문이 없었다는 점이다. 탐색 궤도의 산출물이 곧바로 인도 궤도의 산출물로 서비스에 올랐다. 시제품이 정식판이 되었고, "확정된 것이 무엇인가"를 적어 둔 사람이 없었다.
4단계는 검수 기준을 시공 이전에 쓴다. 테스트가 불합격이면 6단계로 돌아가 프로그램을 고치며, 되돌아가 기준을 느슨하게 하지 않는다. 8단계는 책임자만 할 수 있다.
표 5-2 여러 개발 방식은 "개념 소통"을 어떻게 처리하는가
| 방식 | "무엇을 원하는가"를 어떻게 소통하는가 | 대가 | 이 사례가 취한 것 |
|---|---|---|---|
| 폭포수 | 먼저 완전한 명세서를 쓰고 심사를 마친 뒤에 만든다 | 화면과 느낌은 종이 위에 분명히 쓰기 어려워 오류가 매우 늦게 발견된다 | 인도 궤도의 단계와 관문 |
| 프로토타입 방식, 나선형 | 먼저 한 판을 만들어 보고, 위험이 가장 높은 부분을 반복한다 | 시제품이 흔히 곧바로 정식판이 된다 | 탐색 궤도, 여기에 확정 관문을 더함 |
| 애자일, 이중 궤도 애자일 | 탐색과 인도를 병행하고 주기가 짧다 | 문서의 부족을 메우는 팀의 공동 기억이 필요하다 | 이중 궤도의 구조; 공동 기억은 문서가 맡음 |
| 이 사례(AI 구축) | 시제품에 몇 분이면 되므로 "분명히 쓴 뒤 만들기"를 "만들어 보기"로 대신한다 | AI에게는 대화를 넘나드는 믿을 만한 기억이 없어 확정을 적어 두지 않으면 사라진다 | 확정 후에는 언제나 세 문서에 적는다 |
확정 이후에 무엇으로 쓰이는가는 개념의 종류에 따라 다르다.
표 5-3 각 종류의 개념은 탐색 궤도에서 문서로 어떻게 들어가는가
| 개념 | 탐색 궤도에서 무엇으로 소통하는가 | 확정 후 무엇으로 쓰이는가 | 어떻게 검수하는가 | 이 사례의 예 |
|---|---|---|---|---|
| 흐름 | 흐름도, 클릭할 수 있는 미리보기 판 | 설계서의 단계표: 각 단계의 조건, 다음 단계, 실패 시 처리 | 자동으로 한 번 돌리며 단계별로 대조 | 온라인 법회의 아홉 단계 의궤, 가짜 시계로 전 과정을 완주 |
| 화면 | 비교할 수 있는 여러 디자인 시안, 미리보기 판 | 확정된 스크린샷을 화면 기준으로 삼고, 어길 수 없는 규칙을 더함(예: 글자가 빛을 가리지 않음, 패널이 버튼에 가려지지 않음) | 여러 화면 크기에서 자동 측정 + 수정 전후 스크린샷 | 첫 훈련의 패널 가림 수정 |
| 문자와 어조 | 구축자가 "어디를, 원문, 무엇으로 고칠지"를 제안 | 책임자가 한 자 한 자 확정하여 사전 파일에 기록 | 자동화된 내용 검사 | 공유 카드 소개문, 사이트 지도의 의미 문장 |
| 느낌(애니메이션, 소리, 리듬) | 미리보기 판에서 직접 체험해 보는 수밖에 없음 | 측정할 수 있는 매개변수(시간, 음량, 멈춤)를 설계서에 기록 | 매개변수 대조 + 책임자의 실기 청취·시청 | 염송 리듬, 풍경 소리 음량 |
표 5-2의 마지막 줄이 이 글이 소프트웨어 공학에서 얻은 주된 관찰이다. 여기에는 두 면이 있다.
- AI가 시제품의 비용을 거의 영으로 낮추었으므로 "만들어 보기"가 "분명히 쓰기"보다 싸다.
- 그러나 AI에게는 대화를 넘나드는 믿을 만한 기억이 없으므로, 확정 이후의 문서가 전통적인 팀보다 더 중요하다.
애자일 개발은 "팀의 공동 기억"을 문서의 대체물로 삼는다. 책임자 한 사람에 매번 새로 시작하는 AI 하나에게는 기댈 수 있는 이런 공동 기억이 없다. 이것이 또한 「依法不依人」(법에 의지하고 사람에 의지하지 않는다)의 공학적으로 가장 현실적인 이유이다. 어느 한쪽의 기억에도 의지하지 않기 때문이다.
5.4 RQ3: 첫 번째 완전한 훈련과 그 대가
재정비 자체의 대가. 책임자가 재정비를 요구한 때부터 규범, 서른여섯 건의 기준 문서와 기계 관문이 갖추어지고 스물여덟 장의 변경 요청서가 발행되기까지 약 하루 반이 걸렸다. 이 기간에 책임자가 한 일은 거의 두 가지뿐이었다. 원칙을 정하는 것, 그리고 두 곳의 심사가 일치하지 않을 때 판결하는 것이다. 그의 회신은 나중에는 대개 "좋다"일 뿐이었는데, 매 단계에서 멈출 때마다 문서가 결정할 일을 이미 분명히 써 놓았기 때문이다. 외부 모델의 심사 비용은 몇 달러에 불과했다.
첫 번째 완전한 훈련. 재정비가 끝난 그날 밤, 책임자가 한마디로 제기했다. "휴대전화에서 관역이 버튼에 가려진다." 이 한마디가 여덟 단계를 모두 거쳤다.
표 5-4 첫 번째 완전한 훈련
| 단계 | 산출 | 시간 |
|---|---|---|
| 1 변경 요청서 | A급 시각 변경으로 판정, 입구와 삼전이라는 기둥에 속함; A급은 심사를 면제할 수 있으나 이번에는 훈련으로서 일부러 여덟 단계를 모두 거침 | 약 3분 |
| 2 요구서 | 요구서를 소버전 한 단계 올림; 범위를 "관역"에서 "모든 패널"로 확대 | 위와 같음 |
| 3 설계서 | 네 가지 화면에서 실측으로 재현하고 두 가지 원인을 찾아냄; 채택하지 않을 두 가지 방식을 기록 | 약 4분 |
| 4 테스트서 | 여섯 개 검수 기준; 열 가지 화면, 여섯 가지 언어, 모두 칠백팔십 회의 자동 측정; 책임자 휴대전화 검수 네 항목 | 약 2분 |
| 5 두 곳의 심사 | 두 곳 모두 "수정 후 동의", 의견 모두 열두 항목 | 약 3분 |
| 6–7 개발과 테스트 | 불합격 횟수가 수정 전 368회에서 110회로 감소; 패널 부분은 전부 합격, 남은 것은 모두 다른 버튼의 가림에서 비롯되어 별도의 변경 요청서로 처리 | — |
| 8 검수 | 책임자가 자신의 휴대전화로 확인 | — |
한마디에서 문서와 심사의 완료까지 열두 분이 걸렸다. 심사 비용은 1달러 미만이었다. 테스트서에 따라 측정하면서 이 요청서의 범위 밖에 있는 또 다른 가림 한 곳도 찾아냈다. 그것은 이 요청서의 기준을 느슨하게 하지 않고 별도의 변경 요청서를 열었다.
훈련의 핵심은 속도가 아니라 5단계에 있다. 두 곳의 심사는 착공 이전에 같은 설계 오류를 잡아냈다. 전당 화면은 화면 크기에 따라 비례하여 확대되는데, 원래 설계대로 고정해 쓴 여백이 한 번 더 곱해진다는 점이다. 먼저 프로그램을 썼다면 이 오류는 책임자가 태블릿이나 큰 화면을 들여다볼 때까지 보이지 않았을 것이다. 재정비 이전의 방식이었다면 이것은 다음 번 "수정류 커밋"이 되었을 가능성이 크다.
두 곳 심사의 줄다리기. 두 곳의 심사는 서로 보완하기도 하고 줄다리기를 하기도 한다. 예산제의 변경 요청서는 네 차례 심사했다. 한 곳은 둘째 차례부터 동의 또는 수정 후 동의였고, 다른 한 곳은 넷째 차례까지도 동의하지 않았다. 마지막 두 가지 점은 책임자가 판결하여 변경 요청서의 "알려진 한계"에 올렸다. 이것은 헌장이 설계해 둔 출구이며 고장이 아니다. 불일치의 종착점은 사람이지 세 번째 모델이 아니다.
RQ3에 대한 답. 이 제도에서 "AI로 AI를 심사함"은 수정 가능의 전반부를 담당한다. 결함의 발견을 서비스 이후에서 시공 이전으로 옮기며 비용이 매우 낮다. 이런 심사에는 두 가지 한계가 있다.
- 대조할 문서가 있어야 유효하다. 재정비 기간의 보안 결함은 모두 심사자가 "문서를 따라 실측"할 때에야 발견되었다. 신속 반복기에는 심사가 있었더라도 대조할 "마땅한 모습"이 없었다. 따라서 심사의 유효성은 "근거 있음"이 먼저 성립하는 데 달려 있다. 헌장 1.1판이 "현황을 기록하는 문서"를 프로그램을 열어 대조할 수 있는 심사자에게 맡긴 것도 이 때문이다.
- 심사자가 맹점을 공유할 수 있다. 두 곳이 같은 오류를 잡은 것은 교차 입증이다. 그러나 두 곳이 모두 놓친 오류는 이 사례의 자료에서는 보이지 않는다. 인간 전문가 심사라는 대조가 없으면 재현율을 계산할 수 없다.
그러므로 수정 가능의 후반부(책임 추궁과 최후의 판단)는 반드시 사람에게 남아야 한다.
5.5 생애주기 다섯 단계 대조
표 5-5 재정비 전후의 생애주기
| 단계 | 신속 반복기 | 재정비 후 | 대응 판준 |
|---|---|---|---|
| 요구 | 대화 속에만 있음; 사후에 구술 파일에 기입 | 요구서의 모든 조항에 출처 표시; 확정 후에야 기입 | 근거 있음 |
| 설계 | 프로그램 속에 존재 | 열두 기둥의 설계서; 매 수정마다 먼저 설계서를 고침 | 근거 있음 |
| 개발 | 즉석에서 구현, 즉석에서 서비스 | 변경 요청서, 두 곳의 심사, 등급으로 경중 결정 | 소재 확인 가능, 수정 가능 |
| 검수 | 책임자가 보고 틀렸을 때 제기 | 테스트서가 시공에 앞섬; 자동 측정 + 책임자 직접 검수 | 소재 확인 가능(증은 대신할 수 없음) |
| 운영 | 지출 상한 없음, 문제는 사람이 발견 | 지출 단일 장부와 일일 상한; 문제 센터; 정례 순찰과 재구축 대조 | 수정 가능 |
6. 논의
6.1 팀의 기억이 없을 때, 문서가 곧 기억이다
전통적인 소프트웨어 공학에서 문서는 흔히 팀 기억의 백업으로 간주된다. 쓰지 않아도 기억하는 사람이 있으므로, 애자일 개발은 「작동하는 소프트웨어를 포괄적인 문서보다 중시」할 수 있었다. 본 사례의 조건은 이 관계를 뒤집어 놓았다.
- 구축자는 대화할 때마다 처음부터 다시 시작한다. 맥락이 바뀌면 그가 의지할 수 있는 것은 문서뿐이다.
- 책임자는 자신이 무엇을 원하는지는 기억하지만, 삼 주 전의 어느 말이 어느 파일에 기록되었는지는 기억하지 못한다.
이 조건에서 문서는 기억의 백업이 아니라 기억 그 자체이다. 신속 반복기에도 사실 하나의 「기억」이 있었는데, 수십만 자에 달하는 구술 파일이 그것이다. 그러나 이 파일은 시간순으로 쌓인 것이지 시스템 구조에 따라 조직된 것이 아니었다. 새 결정은 뒤에 덧붙여질 뿐, 옛 결정이 폐기되었다고 표시되지는 않는다. 매 대화마다 다시 읽고, 어느 말이 여전히 유효한지 다시 짐작해야 한다. 기둥 지도와 삼문서가 한 일은 「시간순」 기억을 「구조순」 기억으로 바꾼 것이다. 모든 문제에 대해 조회할 수 있는 고정된 자리가 있고, 현행 버전은 오직 하나뿐이다.
6.2 AI로 AI를 심사하는 일의 한계
본 사례의 심사 설계에는 세 가지 선택이 있으며, 각각 2.5절의 한 가지 편향에 대응한다.
- 심사자는 코드를 작성한 그 대화가 아니도록 하여, 「자기 생성물을 선호하는 경향」을 줄인다.
- 적어도 한 곳은 다른 업체의 모델로 하여, 공유된 학습 편향을 줄인다.
- 심사는 「모순, 누락된 실패, 영향 범위」만 묻고 「잘 썼는가」는 묻지 않아, 장문과 유창한 글을 선호하는 경향을 줄인다.
그러나 이 세 가지 선택은 모두 편향을 줄일 뿐 없애는 것은 아니다. 따라서 본문은 이를 「이종 모델 보조 심사」라고 부른다. 이것은 저비용의 결함 발견 장치이지 책임 추궁의 장치가 아니다.
피조 중개(受造中介)의 관점에서 이 구분은 필요하다. 두 모델이 모두 동의하면 「옳다」고 보는 방식이라면, 「최종적으로 호소되는 말」은 한 모델에서 두 모델로 옮겨 갔을 뿐이다. 헌장이 의견 불일치의 종착점을 책임자에게 두고, 검수는 책임자만 할 수 있다고 정한 것은 심사 자체가 새로운 종국이 되지 않도록 하기 위함이다.
6.3 비용: 민감도 분석
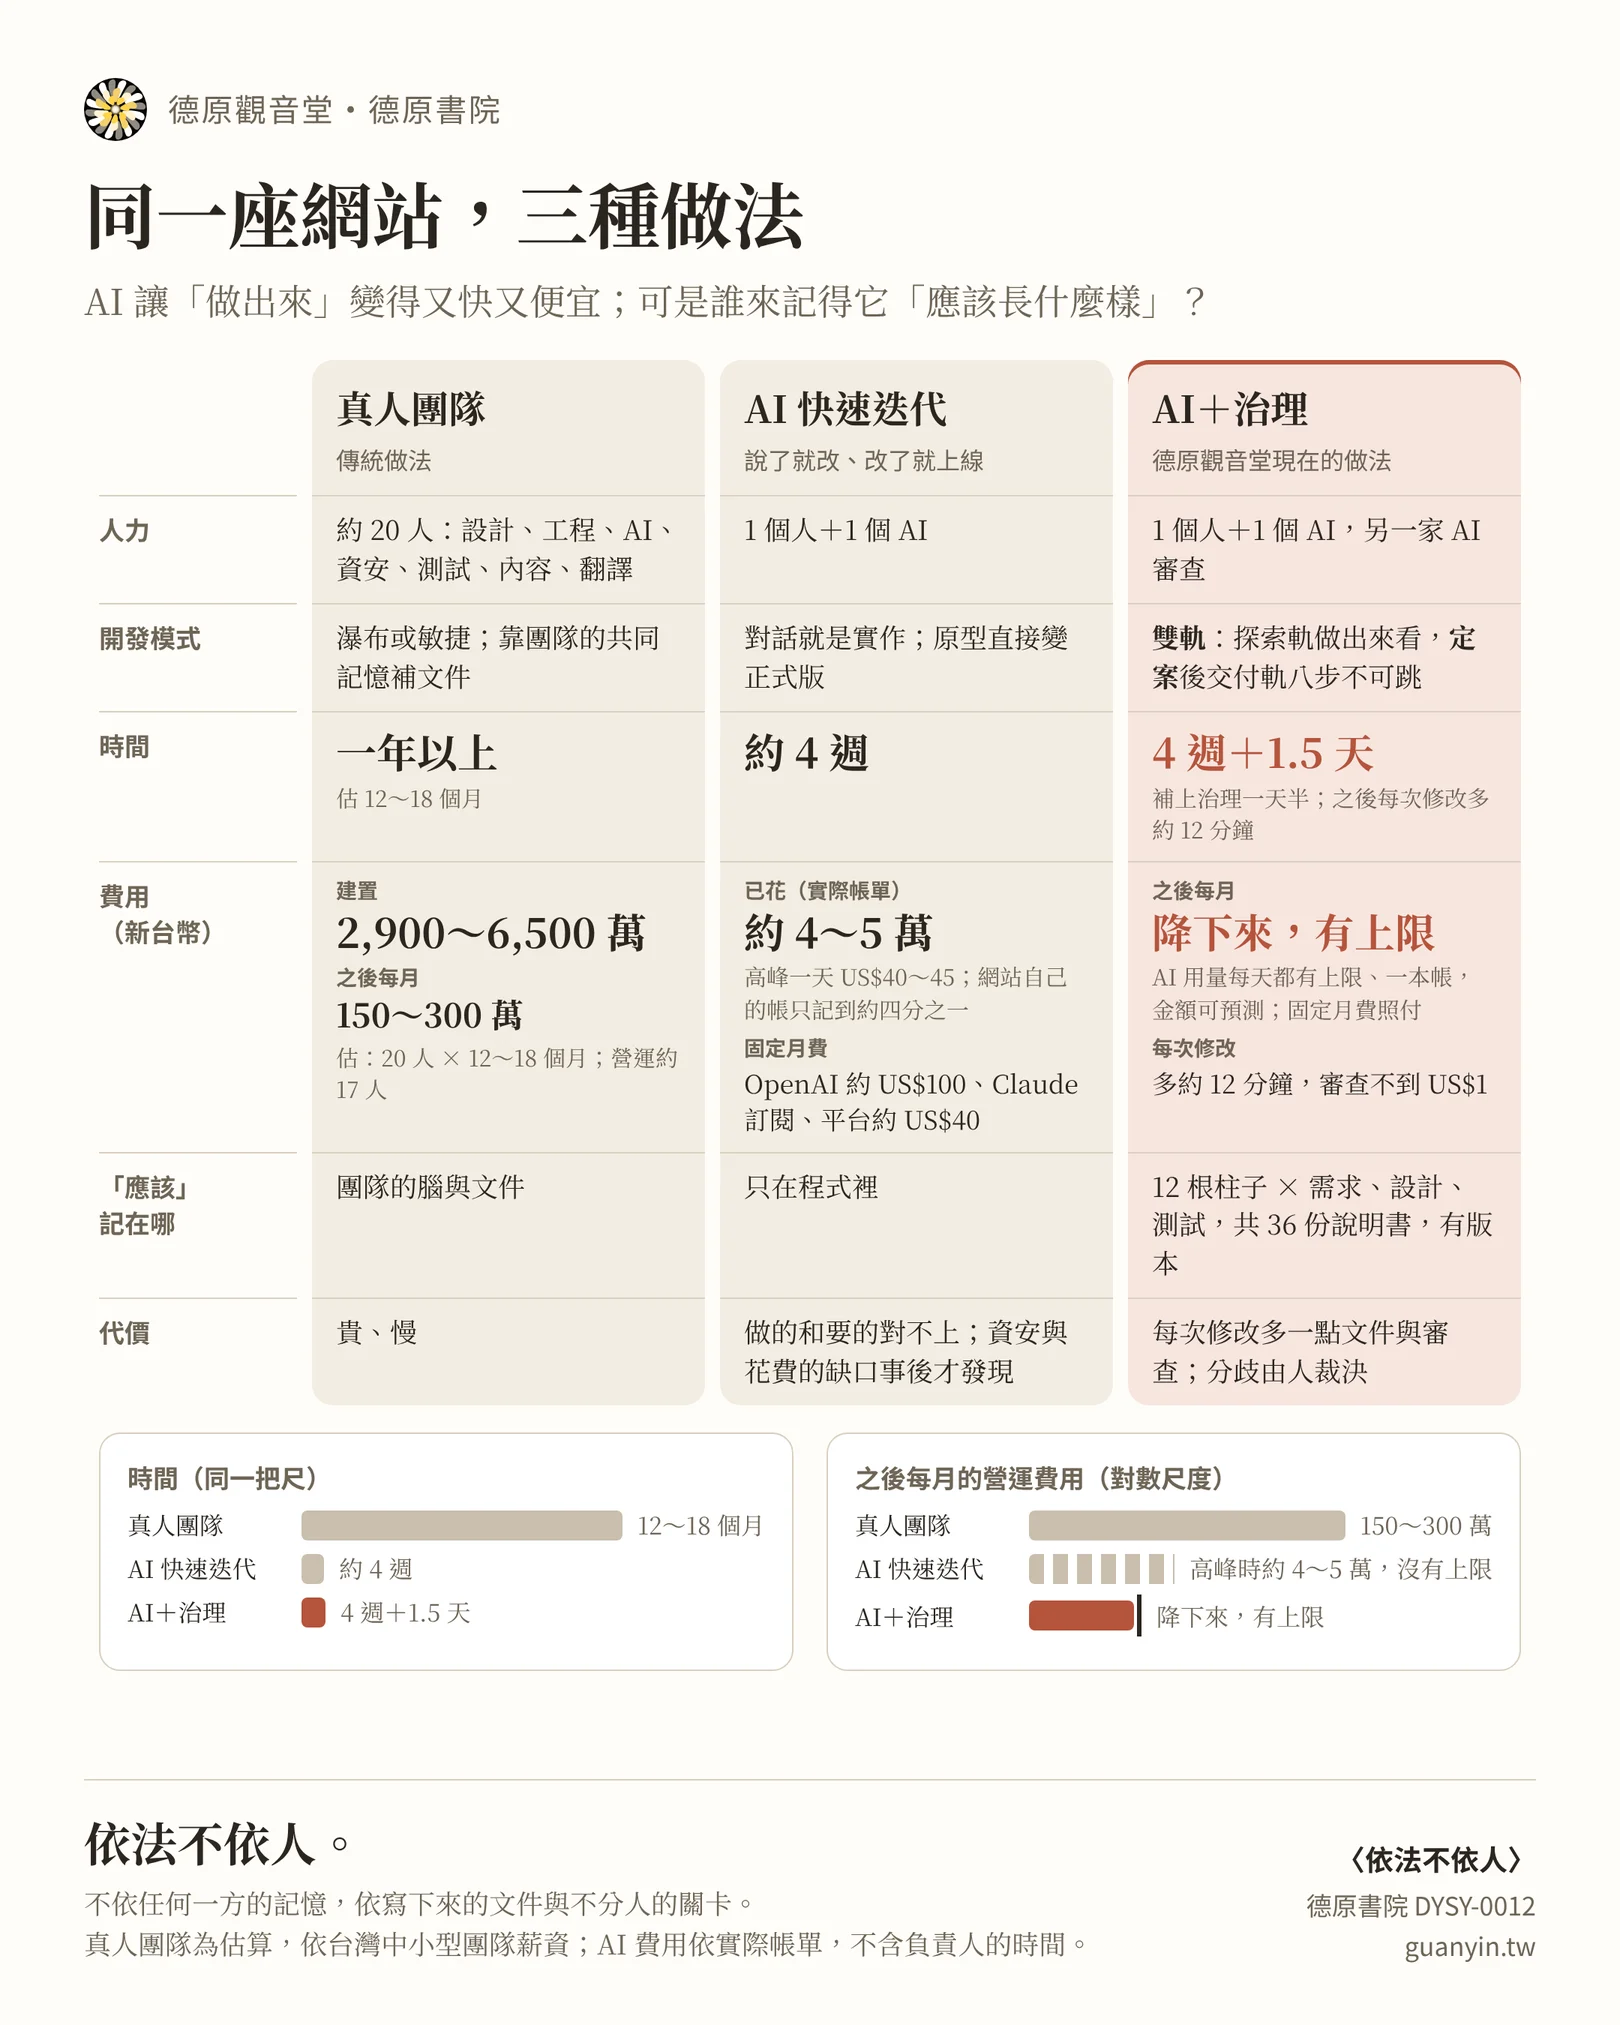
독자는 반드시 이렇게 물을 것이다. 같은 시스템을 실제 사람으로 이루어진 팀이 구축한다면 얼마가 들겠는가? 이 질문에는 하나의 답이 없으며, 그 이유는 세 가지이다.
- 두 쪽의 품질이 같지 않다. 실제 팀에는 전담 보안 및 테스트 인력이 있으나, 본 사례는 신속 반복기에 보안 결함이 발생한 적이 있다.
- 책임자의 시간을 어떻게 값으로 환산하느냐가 결과의 규모를 결정한다.
- 일부는 사람이 대신할 버전이 없다. 예를 들어 생성형 에이전트의 「수학(修學)」 자체가 AI 연구이다.
따라서 본문은 단일 비교를 하지 않고 민감도 분석만 제시한다. 수치는 「실측」과 「추정」으로 나뉜다. 「실측」은 모델 업체의 실제 청구서에서 가져왔고, 「추정」은 산법을 밝혔으며 1달러를 약 신타이완달러 32원으로 환산했다. 웹사이트 자체의 지출 장부는 실제 청구서의 약 4분의 1까지만 기록했고, 나머지는 한 번도 기록되지 않은 호출이다. 이 또한 5.1절 「지출에 상한이 없음」의 일부이다.
표 6-1 구축 비용의 민감도 분석 (신타이완달러)
| 상황 | 산법 | 금액 |
|---|---|---|
| A 책임자 시간을 값으로 치지 않음 | 신속 반복기의 AI 지출을 실제 청구서에 따름 (실측). 정점에는 하루 약 US$40~45. 별도로 고정 월 요금: 외부 모델 약 US$100, 플랫폼 약 US$40, 구축자의 구독료 | 약 4~5만, 고정 월 요금 별도 |
| B 책임자를 전업 제품 관리자로 계산 | 상황 A에 한 사람 한 달, 월 12~18만 (노동·건강보험 및 장비 포함)을 더함 | 약 16~23만 |
| C 책임자를 세 역할로 계산 | 제품 관리자, 영역 전문가, 검수자 각 한 사람 한 달에 상황 A를 더함 | 약 40~59만 |
| D 실제 팀이 구축 | 기능별 분업에 따라 위에서 아래로 추산: 약 스무 명 (디자인, 프런트·백엔드, AI, 보안, 테스트, 불학 콘텐츠, 번역 포함) × 12~18개월 × 월 12~18만 | 약 2,900~6,500만 |
시간상의 차이는 표에 들어 있지 않다. 본 사례는 약 한 달이 걸렸고, 실제 팀의 추산은 일 년 이상이다. 표의 수치도 「몇 배 저렴하다」로 읽어서는 안 되며, 이 수치들이 뒷받침할 수 있는 결론은 두 가지뿐이다.
첫째, 책임자를 어떻게 값으로 환산하든 (A에서 C까지) AI 구축의 금전적 비용은 실제 팀보다 훨씬 낮다. 책임자의 시간을 계산하지 않을 때는 차이가 거의 세 자릿수 규모이고, 책임자의 세 역할을 모두 전업으로 계산해도 여전히 수십 배 이상 차이가 난다. 차이가 워낙 커서 품질의 불균등을 감안하더라도 방향은 뒤집히지 않는다. 그러나 이 차이는 공짜로 얻은 것이 아니며, 위험의 위치를 바꾸어 놓았다. 실제 팀에서는 전담 보안 및 테스트 인력이 지던 위험을 본 사례에서는 문서, 심사, 관문이 진다. 제5절에서 서술한 것이 바로 이러한 위험을 지는 이가 없을 때 무슨 일이 일어나는지이다.
둘째, AI 구축의 주된 비용은 예상했던 항목이 아니다. 본 사례에서 가장 큰 단일 지출원은 시스템 기능 자체가 아니라 「상한이 없음」이었다. 신속 반복기 초반부터 예산제가 있었다면, 반사실적 추산으로는 AI 지출의 대부분을 아낄 수 있었을 것이다. 다만 이 추산에는 감액이 따라야 한다. 초과 지출로도 「해 보아야 아는」 지식을 얻었기 때문이다. 더 정확한 표현은, 예산제는 시도를 막지 않고 시도가 이미 알려진 금액 안에서 일어나게 할 뿐이라는 것이다.
재정비 후 매 수정의 추가 비용은 십수 분의 문서 작업과 심사, 그리고 1달러에 못 미치는 심사비이다 (5.4절). 이는 한 차례 시연의 관찰이지 평균값이 아니다.
6.4 영역 규범이 검사 가능한 명세가 되다
종교 현장의 규범은 보통 「무른」 것으로 간주된다. 사람의 판단에 의존하며 규칙으로 쓰기 어렵다는 것이다. 본 사례의 경험은 그 가운데 일부가 매우 「단단」할 수 있다는 것이다.
| 영역 규범 | 공학상의 형식 |
|---|---|
| 경문 한 글자도 고치지 않음 | 인용문은 프로그램이 경문 원문과 글자 단위로 대조하여 검증하며, 번역 시에는 프로그램이 경문 필드를 원문으로 덮어씀 |
| 대변하지 않고 가호를 말하지 않음 | 금지어 스캔. 부적합한 내용은 한 번 다시 쓰고, 그래도 부적합하면 게시하지 않음 |
| 위기 시 먼저 연계 | 안전 등급이 위기로 판정되면 생성 모델을 호출하지 않고, 고정된 문구와 전화 상담 번호를 곧바로 회신 |
| 「실」은 움직일 수 없음 | 기둥 지도의 기초에 두며, 한 글자를 고치려 해도 가장 무거운 D급 절차를 거쳐야 함 |
단단하게 만들 수 없는 부분, 예컨대 「이 말의 어조가 온화한가」 같은 것은 「구축자가 제안하고 책임자가 글자 단위로 확정하는」 길을 간다 (표 5-3). 이 경계 자체가 설계이다. 단단하게 만들 수 있는 것은 기계에 맡기고, 그럴 수 없는 것은 사람에게 맡겨, 모델이 그 둘 사이의 일을 판단하지 못하게 한다.
6.5 일반화 가능성
본 사례에는 복제하기 쉽지 않은 전제가 하나 있다. 책임자 한 사람이 제품 관리자, 영역 전문가, 검수자를 겸임했다는 점이다. 다른 현장에서는 이 세 역할이 서로 다른 사람에게 나뉘어 있을 수 있다. 아래의 방식들은 종교 현장과 무관하며 그대로 가져갈 수 있다.
- 기둥 지도와 삼문서의 구조
- 말의 분류와 5단계 변경
- 「테스트를 완화할 수 없음」과 「오류를 고치기 전에 먼저 테스트를 보충」이라는 두 규칙
- 주선 보호와 데이터베이스 재구축 대조
- 지출 단일 장부
새 프로젝트에 대해 본 사례가 시사하는 바는 순서이다. 기계 관문은 빈 프로젝트일 때 이미 놓여 있어야 하며, 본 사례는 시스템이 이미 자란 뒤에야 보충했다. 개인정보나 의료 조언의 오류 비용이 더 높은 영역, 예컨대 건강 서비스에서는 이 순서가 더욱 필요하다.
여러 사람이 함께 운영하려면 가장 큰 위험은 「두 사람이 같은 곳에 대해 각자 다른 말을 하는 것」이다. 가능한 방법은 다음과 같다.
- 기둥별로 사람을 나눈다.
- 변경서를 유일한 진입로로 삼는다.
- 같은 기둥에는 한 번에 하나의 중대 변경만 연다.
- 관문은 모든 사람에게 똑같이 적용한다.
이 점은 본 사례에서 아직 구현되지 않았다.
7. 타당도 위협과 한계
이 절은 Runeson과 Höst(2009)의 네 가지 타당도 유형에 따라 차례로 서술하고, 끝에서 연구자의 위치를 밝힌다.
구성 타당도. 세 가지 판준은 철학적 논증에서 나왔으므로, 이를 공학 지표로 옮길 때 두 가지 위험이 있다.
- 지표가 조치 그 자체만을 측정할 수 있다. 예컨대 「변경 단이 있다」는 「위치를 확인할 수 있다」와 같지 않다. 따라서 이 글은 빠른 반복기를 서술할 때 부재의 징후(표 3-2)만을 사용하고, 조치의 존재로 개선을 증명하지 않는다.
- 「수정 유형 커밋」은 커밋 메시지의 어휘로 판단한 것이어서 누락될 수 있고, 오분류될 수도 있다.
내적 타당도. 재정비 전후의 차이에 대해 이 글은 인과적 주장을 하지 않는다. 이유는 세 가지다.
- 재정비는 시스템의 성숙과 동시에 일어났다. 후기의 수정이 적은 것은 기능이 이미 완성되었기 때문일 수 있다.
- 운영 원칙인 「현 단계에서는 적게 한다」 자체가 변경량을 낮춘다.
- 재정비 후 완전한 연습은 한 차례뿐이어서, 평균적인 비용과 효과를 추론하기에는 부족하다.
외적 타당도. 이는 단일 사례이며 세 가지 특수한 조건이 있다.
- 현장이 종교 도량이며 비용을 받지 않는다.
- 책임자 한 사람이 세 가지 역할을 겸한다.
- 구축자는 특정 시점의 특정 모델이다.
모델의 능력과 기억 기제는 변화가 매우 빠르다. 「대화를 넘나드는 신뢰할 만한 기억이 없다」는 전제가 바뀐다면 문서의 역할도 함께 바뀔 수 있다. 이 글의 주장은 분석적 일반화이다. 곧 「팀의 공동 기억이 없고, 구현자와 심사자가 같은 계통일 수 있는」 형태로 일반화되는 것이며, 통계적 일반화가 아니다.
신뢰성. 코딩은 구축자가 수행하고 책임자가 재검토하였으며, 외부 코더도 일치도 지표도 없다. 빠른 반복기의 비용은 모델 업체의 실제 청구서를 기준으로 한다. 웹사이트 자체의 장부는 약 4분의 1까지만 기록되어 있어 기능별로 하나하나 대응시킬 수 없다. 구축자 자신의 사용료는 구독제여서 건별 장부가 없다.
기준 문서의 시간 순서. 서른여섯 건의 기준 문서는 재정비 때 기존 프로그램을 바탕으로 역추적하여 작성한 것이며, 「문서가 프로그램에 앞선다」는 원칙의 산물이 아니다. 이 글의 「문서가 프로그램에 앞선다」는 재정비 이후의 수정에만 적용된다.
연구자의 위치. 연구자는 곧 참여자이다.
- 이 글의 초고는 구축자가 썼는데, 구축자는 연구 대상이 된 역할 가운데 하나이다.
- 책임자는 제도의 설계자이면서 결과의 확정자이기도 하다.
이로 인해 「자신의 제도를 지나치게 좋게 쓰는」 편향이 생길 수 있다. 구축자가 자기 자신에 대해 쓰는 것은 2.5절의 「자기 생성물을 선호함」에 해당하는 경우이기도 하다. 이 글은 두 가지 완화 조치를 취했다.
- 개요는 두 모델의 검토를 거쳤고, 전문은 또 다른 독립적인 AI 세션이 공격자의 관점에서 검토하였다.
- 실패 양상과 결함은 모두 기록에 남은 사건을 근거로 하며, 기억을 근거로 하지 않는다.
이러한 완화 조치가 외부 연구자를 대신할 수는 없다.
후속 연구의 설계. 위의 한계는 후속 연구에서 다룰 수 있으며, 권하는 방식은 다음과 같다.
- 관찰 기간을 사전에 등록한다. 최소 60일, 최소 20건의 변경 단을 포함하고 각 등급을 아우르도록 한다. 재정비가 이루어진 하루 반은 과도기로 보아 어느 기간에도 산입하지 않는다.
- 조치와 독립적인 지표로 두 기간을 비교한다. 예컨대 다음과 같다.
- 상선(上線) 후 「한 것과 요구한 것이 다르다」는 문제의 수
- 상선 후 결함 가운데 결정까지 추적할 수 있는 비율
- 변경 실패율, 롤백 횟수, 7일 이내 재발 수
- 반증 조건을 미리 밝혀 둔다. 세 가지 판준 가운데 적어도 두 가지의 지표에서 관찰 기간이 회고 기간보다 우수해야 지지로 간주한다.
- 변경 단을 표집하여 인간 전문가가 독립적으로 심사하게 하고, 두 AI의 심사 및 상선 후 실제 결함과 삼자 대조하여 재현율(recall)을 산출한다.
- 외부 연구자 한 사람을 초청하여 표본을 독립적으로 코딩하게 하고, 일치도를 보고한다.
8. 결론
프로그램을 직접 작성하지 않는 책임자 한 사람과 AI 구축자 하나가 약 한 달 안에 완전한 시스템을 구축할 수 있다. 그러나 문서로 적어 둔 「응당 그러해야 함」이 없다면, 그 시스템은 검수할 수도, 예측할 수도, 지켜 낼 수도 없다.
연구 문제에 대한 답:
- RQ1: 빠른 반복 시기의 실패는 세 가지로 분류할 수 있다. 첫째, 「응당 어떠해야 하는가」가 프로그램 안에만 존재한다. 둘째, 수정이 결정을 추적하지 못하고 상태를 재구성할 수 없다. 셋째, 보안과 비용의 공백이 사후에야 발견된다. 이 셋은 각각 근거 있음, 위치 확인 가능, 수정 가능의 부재에 대응한다. 세 가지는 서로 증폭시킨다. 문서가 없으면 검토는 대조할 기준이 없다.
- RQ2: 공백을 메운 것은 규범, 문서, 절차, 기계 관문이라는 네 층의 제도이다. 각 층은 어느 한쪽의 기억에 의존하지 않는다. 명확히 적기 어려운 개념은 이중 궤도로 다룬다. 탐색 궤도에서는 자유롭게 시험 제작하고, 확정한 뒤에야 문서에 적어 인도 궤도로 들인다.
- RQ3: 첫 번째 완전한 시연에서는 한마디 말에서 문서와 두 곳의 검토 완료까지 한 각(약 15분)도 걸리지 않았고, 검토는 착수 전에 설계 오류 하나를 찾아냈다. 「AI로 AI를 검토하는 일」은 수정 가능한 전반부를 담당할 수 있다. 이는 결함의 발견을 앞당기고 비용도 극히 낮추지만, 전제는 대조할 문서가 있다는 것이다. 책임과 최종 판단은 사람에게 남아야 한다.
실무에 대한 제언은 「한 사람+AI 하나」로 개발하는 이들을 대상으로 한다.
- 첫 줄의 프로그램을 쓰기 전에 기계 관문부터 갖추어 둔다. 주 분기 보호, 자동 검사, 데이터베이스 재구축 가능성, 비용 상한이 그것이다. 이 가운데 어느 하나도 프로그램을 아는 사람이 지킬 필요가 없다.
- 「만들어서 보는 일」은 값싸게 유지하되, 「확정」하는 순간에 그 결과를 문서에 적는다. 시제품은 정식 버전과 같지 않다.
- 어떤 오류를 고치든 먼저 시험을 보강한다. 프로그램을 통과시키려고 시험을 느슨하게 하지 않는다.
- 검토자는 프로그램을 작성한 그 대화이면 안 된다. 되도록 서로 다른 업체의 것이 하나 있어야 한다. 견해가 갈릴 때의 종착점은 사람에게 두고, 세 번째 모델에 두지 않는다.
- 기능을 거둘 때는 프런트엔드와 백엔드, 스케줄도 함께 거둔다.
「의법불의인(依法不依人)」은 이 글에서 종교적 구호가 아니라 공학적 판단이다. 구현자가 매번 잊어버리고 책임자는 프로그램을 볼 수 없을 때, 시스템의 정확성은 적어 두고 버전이 있으며 모든 이에게 똑같은 것에 의지할 수밖에 없다. AI는 손가락이지 달이 아니다. 방문자에게 그러하듯, AI가 스스로 쓴 프로그램에 대해서도 그러하다.
참고문헌
- Becker, J., Rush, N., Barnes, B., & Rein, D. (2025). Measuring the impact of early-2025 AI on experienced open-source developer productivity. METR. arXiv:2507.09089. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- Boehm, B. W. (1988). A spiral model of software development and enhancement. Computer, 21(5), 61–72.
- Delimarsky, D. (2025, September 15). Diving into spec-driven development with GitHub Spec Kit. Microsoft for Developers. https://developer.microsoft.com/blog/spec-driven-development-spec-kit/
- Gotel, O., & Finkelstein, A. (1994). An analysis of the requirements traceability problem. In Proceedings of the First International Conference on Requirements Engineering (pp. 94–101). IEEE Computer Society Press.
- Panickssery, A., Bowman, S. R., & Feng, S. (2024). LLM evaluators recognize and favor their own generations. In Advances in Neural Information Processing Systems 37. arXiv:2404.13076.
- Peng, S., Kalliamvakou, E., Cihon, P., & Demirer, M. (2023). The impact of AI on developer productivity: Evidence from GitHub Copilot. arXiv:2302.06590.
- Royce, W. W. (1970). Managing the development of large software systems. In Proceedings of IEEE WESCON (pp. 1–9).
- Runeson, P., & Höst, M. (2009). Guidelines for conducting and reporting case study research in software engineering. Empirical Software Engineering, 14(2), 131–164.
- Sy, D. (2007). Adapting usability investigations for agile user-centered design. Journal of Usability Studies, 2(3), 112–132.
- Zheng, L., Chiang, W.-L., Sheng, Y., et al. (2023). Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. In Advances in Neural Information Processing Systems 36, Datasets and Benchmarks Track. arXiv:2306.05685.
- AI as a Created Mediator: Generativity, Grounding, and the Idolatry of the Interface (미간행 원고).
- 般剌蜜帝譯。《大佛頂如來密因修證了義諸菩薩萬行首楞嚴經》卷二。CBETA T19n0945, p. 111a09–a11。
- 曇無讖譯。《大般涅槃經》卷六。CBETA T12n0374, p. 401b28–b29。
본 사이트 문헌: 덕원서원 DYSY-0002〈照見〉, DYSY-0004〈從生成式代理人到數位同修〉, DYSY-0006〈德原觀音堂設計理念與運作實務〉, DYSY-0008〈由智生悲〉, DYSY-0011〈中介者的自我要求〉; 「AI 도량」 페이지의 사이트 지도.